Le cache de plans de SQL Server
Categories:
125 minutes à lire
Article coécrit avec Claude, qui a mené une grande partie des tests et des recherches.
Le cache de plans (plan cache) est la partie de la mémoire où SQL Server conserve les plans d’exécution, pour ne pas recompiler sans cesse les mêmes requêtes. Depuis SQL Server 2005, il est composé de quatre stores, dont deux contiennent des plans, SQL Plans pour les batchs ad hoc et préparés, Object Plans pour les procédures et les déclencheurs. Vous pouvez en voir le détail avec la vue sys.dm_exec_cached_plans.
Un plan ad hoc ou préparé est retrouvé par le texte exact de son batch entier, caractère par caractère ; un plan de procédure, de fonction ou de déclencheur, par l’identifiant de l’objet. Le moteur compare aussi une série d’attributs, la clé du cache, dont les options SET de la session et, quand un nom n’est pas qualifié, le schéma par défaut de l’utilisateur.
Pour qu’un plan soit paramétré et serve à plusieurs valeurs, celle-ci doit sortir du texte de la requête. Le moteur le fait lui-même par le paramétrage simple, actif par défaut mais limité aux requêtes dont le plan ne dépend pas de la valeur, ou par le paramétrage forcé, qu’on active par base et qui paramètre presque tout. Le client le fait par sp_executesql avec de vrais paramètres, ou en appelant des procédures stockées. Un identifiant concaténé dans le texte, même passé à sp_executesql, produit un plan par valeur.
SQL Plans et Object Plans ont chacun deux limites : un seuil de 160 036 entrées, quatre fois les 40 009 buckets de leur table de hachage, et une taille qui dépend de la mémoire cible. Une entrée a un coût, que l’horloge du cache fait baisser sous pression et qui remonte à chaque réutilisation.
Un plan quitte le cache par éviction ou par vidage : DBCC FREEPROCCACHE, ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE, et certaines reconfigurations, comme max degree of parallelism, qui vident le cache de toute l’instance. Une invalidation déclenche au contraire une recompilation dans la même entrée, avec le même plan_handle.
Le cache de plans
Avant d’exécuter une requête, SQL Server la compile : il l’analyse, résout les noms des objets, puis l’optimiseur cherche un plan d’exécution.
Pour une requête simple, cela prend quelques millisecondes ; pour une requête de vingt tables ou une liste IN de 20 000 littéraux, plusieurs secondes.
Le cache de plans (plan cache en anglais, procedure cache dans les anciennes versions) garde le résultat de ce travail, le plan compilé, pour que l’exécution suivante de la même requête s’en serve directement.
L’idée remonte au premier prototype de SGBD relationnel. En 1981, l’équipe d’IBM qui avait construit System R et inventé le langage SQL raconte dans A History and Evaluation of System R (Donald D. Chamberlin et quinze coauteurs, Communications of the ACM, vol. 24, n° 10, octobre 1981, p. 632-646) comment les instructions SQL d’un programme étaient compilées une fois en routines rassemblées dans un module d’accès (access module), dont la liste des tables et des index utilisés était enregistrée dans le catalogue. Un DROP INDEX marquait les modules concernés comme invalides, et le module était recompilé au prochain appel, sans que l’utilisateur s’en aperçoive. Leur mesure justifie encore le cache : sur un IBM 370/168, pour une jointure de deux tables, l’analyse et le choix du chemin d’accès coûtaient environ 94 ms de processeur, la génération du code 19 ms, la lecture d’une ligne du résultat 8,7 ms.
Le plan d’exécution réutilisé, les dépendances enregistrées, l’invalidation par un changement de schéma, la recompilation paresseuse (lazy) à l’appel suivant : toutes choses que SQL Server et de nombreux SGBDR font encore aujourd’hui. Comme dans System R, le cache garde une structure exécutable en mémoire.
Dans les années 1990, SQL Server 6.5 ne gardait en cache que les plans des procédures stockées. La version 7.0 a commencé à conserver aussi les plans des requêtes ad hoc et du SQL dynamique, et SQL Server 2005 a donné au cache sa forme actuelle : des stores bâtis sur le cadre commun des caches de SQLOS, des vues de gestion dynamique pour les lire, et la recompilation instruction par instruction au lieu du batch entier, ou de toute la procédure stockée. Les versions suivantes ont ajouté des réglages et des fonctionnalités supplémentaires :
optimize for ad hoc workloadsen 2008,CLEAR PROCEDURE_CACHEen 2016,- l’optimisation des plans sensibles aux paramètres (PSP) en 2022,
- l’optimisation des paramètres facultatifs (OPPO)
- l’option de base
OPTIMIZED_SP_EXECUTESQLen 2025).
Tout cela sans changer la structure fondamentale du cache.
Le cache est évidemment volatile : il disparaît au redémarrage du service, et un plan peut en sortir à tout moment. C’est ce qui le distingue du Query Store, qui conserve les plans et leurs statistiques d’exécution dans la base.
J’ai déjà traité plusieurs parties du sujet dans des articles séparés :
- Le plafond d’entrées du cache de plans pour les limites et l’éviction,
- La recompilation des plans et Les statistiques et les plans en cache pour l’invalidation,
- Les listes IN de littéraux pour le paramétrage et les stubs.
Je détaille ici ce que contient le cache, comment le moteur retrouve un plan, ce qu’il met en cache, ce qu’il retire et ce qui vide le cache.
Les mesures ont été effectuées essentiellement par Claude, sur des conteneurs jetables de SQL Server 2025 CU10 (17.0.5035.5) sous Linux, avec une mémoire limitée à 2 048 Mo, sauf mention contraire. Les mesures principales ont été refaites sous Windows Server 2019, sur une instance 2025 CU9 (17.0.5015.4). Toutes ont donné les mêmes valeurs que sous Linux.
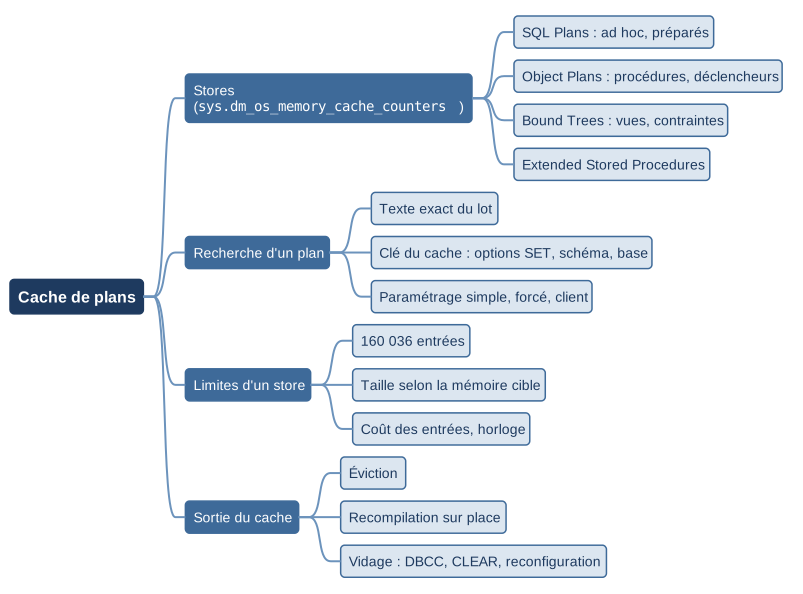
Les stores
Le cache de plans n’est pas une structure unique. C’est un ensemble de stores (cache stores) de SQLOS, la couche du moteur qui gère la mémoire et les processeurs. Chaque store a sa table de hachage (hash table), son compteur d’entrées, son horloge d’éviction, et un nom de type qui commence par CACHESTORE_. Quatre stores forment le cache de plans au sens de la documentation :
| store | Type | Contenu |
|---|---|---|
| SQL Plans | CACHESTORE_SQLCP | plans des batchs ad hoc, des requêtes paramétrées automatiquement, de sp_executesql et des instructions préparées |
| Object Plans | CACHESTORE_OBJCP | plans des procédures stockées, des fonctions et des déclencheurs |
| Bound Trees | CACHESTORE_PHDR | arbres algébrisés (bound trees) des vues, des contraintes et des valeurs par défaut |
| Extended Stored Procedures | CACHESTORE_XPROC | nom et bibliothèque des procédures étendues, comme sp_executesql lui-même |
Les objets de compteurs de performance SQLServer:Plan Cache comptent une cinquième instance, Temporary Tables & Table Variables (CACHESTORE_TEMPTABLES), qui garde les tables temporaires mises en cache par les procédures. Elle a ses propres règles, que j’ai décrites dans La durée de vie des tables temporaires mises en cache.
Le texte des requêtes se trouve dans le cache SQL Manager, un objet mémoire de type MEMOBJ_SQLMGR. Il suit une autre règle d’éviction que les stores : une entrée de texte reste tant qu’au moins un plan y fait référence.
La taille des tables de hachage se lit dans sys.dm_os_memory_cache_hash_tables :
SELECT name, type, buckets_count, buckets_in_use_count
FROM sys.dm_os_memory_cache_hash_tables
WHERE type IN (N'CACHESTORE_SQLCP', N'CACHESTORE_OBJCP',
               N'CACHESTORE_PHDR', N'CACHESTORE_XPROC');
Les tables de hachage SQL Plans et Object Plans ont 40 009 buckets, Bound Trees 4 001, Extended Stored Procedures 127.
Ce sont des nombres premiers, que les livres sur les internals arrondissent à « environ 40 000 ».
Le bucket d’une entrée est calculé comme (object_id × database_id) mod taille de la table, d’après Sangeetha Shekar, de l’équipe de programmabilité de SQL Server, en 2007, et Kalen Delaney dans Microsoft SQL Server 2012 Internals.
Pour un plan ad hoc ou préparé, l’object_id est un hachage du texte du batch. Le produit est calculé sur un entier de 32 bits non signé, qui déborde : je l’ai vérifié sur 36 entrées (voir « Les identifiants d’un plan »).
L’indicateur de trace (trace flag) 174 fait passer les deux tables de plans à 160 001 buckets, et j’ai mesuré qu’il fait aussi passer Bound Trees à 16 001, ce qui n’est pas documenté (voir l’article sur le plafond).
40 009 est le premier nombre premier supérieur à 40 000. Le nombre premier a un intérêt pour le calcul modulo : si la table avait 40 000 buckets et que database_id valait 2, le produit object_id × database_id serait toujours pair ; seuls les buckets pairs pourraient être atteints. Avec 40 009, multiplier par 2 ne restreint pas ainsi les résultats du modulo, car 2 et 40 009 sont premiers entre eux.
Le nombre premier limite ce type de concentration, sans garantir une répartition uniforme : celle-ci dépend aussi des identifiants hachés. L’exemple illustre le principe mathématique ; le calcul réel comporte le débordement sur 32 bits décrit plus haut. Je n’ai pas trouvé d’explication publiée par Microsoft sur le choix précis de 40 000 comme taille cible.
On trouve ce que contient le cache dans la DMV sys.dm_exec_cached_plans, une ligne par entrée :
SELECT p.cacheobjtype, p.objtype, p.usecounts, p.size_in_bytes,
       p.plan_handle, LEFT(t.text, 80) AS debut_du_texte
FROM sys.dm_exec_cached_plans AS p
CROSS APPLY sys.dm_exec_sql_text(p.plan_handle) AS t
ORDER BY p.size_in_bytes DESC;
La colonne cacheobjtype donne la nature de l’entrée :
Compiled Planpour un plan compilé,Compiled Plan Stubpour un stub (voir plus loin),Parse Treepour un arbre de Bound Trees,Extended Procpour une procédure étendue.
La colonne objtype donne l’origine : Adhoc (en un mot, et non « Ad hoc » comme l’écrit la page de documentation de sys.dm_exec_cached_plans sur Microsoft Learn), Prepared, Proc, Trigger, View, Check, Default, UsrTab, SysTab, ReplProc, Rule.
Après six batchs simples, le cache d’une base de test contenait par exemple des entrées Adhoc de 16 384 octets, une jointure ad hoc de 57 344 octets, des plans Prepared de 49 152 à 57 344 octets, une procédure de 98 304 octets, et deux Extended Proc de 8 192 octets, sp_executesql et xp_msver. La procédure sp_executesql est elle-même une procédure étendue mise en cache dans XPROC. Les entrées Adhoc de 16 384 octets ne contiennent pas de plan d’exécution : ce sont des shell queries, des entrées qui gardent le texte d’origine d’une requête paramétrée par le moteur et renvoient vers le plan paramétré (voir « Le paramétrage simple »).
La colonne bucketid de sys.dm_exec_cached_plans donne le numéro du bucket de chaque entrée en cache :
SELECT p.plan_handle, p.bucketid, p.memory_object_address,
       p.objtype, p.cacheobjtype, LEFT(t.text, 80) AS debut_du_texte
FROM sys.dm_exec_cached_plans AS p
OUTER APPLY sys.dm_exec_sql_text(p.plan_handle) AS t
ORDER BY p.bucketid, p.objtype;
Pour retrouver un plan précis, on peut filtrer sur son plan_handle. Le numéro du bucket est relatif à la table de hachage du store : deux entrées de stores différents peuvent avoir le même bucketid. La colonne memory_object_address désigne l’objet mémoire de l’entrée, pas l’adresse du bucket. La DMV sys.dm_os_memory_cache_hash_tables donne les statistiques des tables de hachage, mais pas l’adresse de chaque bucket.
La taille d’une entrée
Longtemps j’ai pensé que les plans en cache sont gros parce qu’ils sont stockés en XML. Le plan en cache est en réalité une structure binaire : un arbre d’objets du moteur reliés par des pointeurs, rangé dans des objets mémoire de SQLOS. Le XML que montrent SSMS et sys.dm_exec_query_plan est fabriqué à la demande à partir de cette structure, puis jeté. Sur quinze plans de complexité croissante, j’ai demandé à Claude de comparer size_in_bytes à la taille du XML que rend sys.dm_exec_query_plan :
| Plan | size_in_bytes | XML en nvarchar | XML / taille |
|---|---|---|---|
| shell query du paramétrage simple | 16 384 | 1 068 | 7 % |
COUNT(*) d’une table | 49 152 | 6 360 | 13 % |
| jointure de deux tables | 81 920 | 15 670 | 19 % |
| jointure de trois tables | 139 264 | 18 744 | 13 % |
| jointure de neuf tables | 360 448 | 47 836 | 13 % |
| procédure de trois instructions | 204 800 | 15 528 | 8 % |
sp_executesql | 49 152 | 5 822 | 12 % |
Le XML pèse de 2 à 30 % de l’entrée. Le lire ne change ni size_in_bytes ni usecounts : il n’est pas conservé.
Le débogueur le confirme : sur une exécution d’un plan en cache, la fonction qui fabrique le XML (CSQLSource::FBuildXMLShowplan, dans sqllang.dll) n’a pas été appelée ; une lecture de sys.dm_exec_query_plan l’a appelée une fois.
Les deux premières exécutions l’avaient appelée aussi, mais par GenerateShowplanForQDS : le Query Store, actif sur la base, demandait le plan pour le stocker, à la compilation et, vraisemblablement pour la même raison, à l’exécution suivante. Pour mesurer la taille de l’entrée, je l’ai rattachée aux objets mémoire qui la composent. memory_object_address désigne un objet MEMOBJ_COMPILE_ADHOC (pour tous les types, Proc compris), et chaque plan a son propre allocateur de pages : les objets de sys.dm_os_memory_objects qui partagent cet allocateur (page_allocator_address) font exactement size_in_bytes, à l’octet près, sur les dix-neuf entrées vérifiées.
WITH p AS (
    SELECT cp.plan_handle, cp.objtype, cp.size_in_bytes, mo.page_allocator_address
    FROM sys.dm_exec_cached_plans AS cp
    JOIN sys.dm_os_memory_objects AS mo
      ON mo.memory_object_address = cp.memory_object_address
    WHERE cp.cacheobjtype = N'Compiled Plan'
)
SELECT p.objtype, p.size_in_bytes, m.type, COUNT(*) AS nb_objets,
       SUM(m.pages_in_bytes) AS octets
FROM p
JOIN sys.dm_os_memory_objects AS m
  ON m.page_allocator_address = p.page_allocator_address
GROUP BY p.plan_handle, p.objtype, p.size_in_bytes, m.type
ORDER BY p.size_in_bytes DESC, octets DESC;
Une entrée contient ainsi plusieurs objets, dont les noms ne sont pas documentés ; leur rôle se déduit de leur comportement :
| Objet mémoire | Ce qu’il contient | Jointure de 2 tables | Jointure de 9 tables |
|---|---|---|---|
MEMOBJ_COMPILE_ADHOC | le plan compilé | 32 Ko | 104 Ko |
MEMOBJ_STATEMENT | une instruction compilée d’un module (procédure) | ||
MEMOBJ_XSTMT | une instruction exécutable d’un batch de plusieurs instructions | ||
MEMOBJ_EXECUTE | le contexte d’exécution (voir la section suivante) | 24 Ko | 104 Ko |
MEMOBJ_QUERYEXECCNTXTFORSE | la partie du contexte propre au moteur de stockage | 24 Ko | 144 Ko |
size_in_bytes compte le plan et ses contextes d’exécution gardés en cache : pour la jointure de neuf tables, 104 Ko de plan et 248 Ko de contexte. Chaque objet alloue par pages de 8 Ko, d’où des tailles toujours multiples de 8 192. Seuls les stubs de optimize for ad hoc workloads (456 et 136 octets) échappent à cette règle : ils n’ont pas d’objet mémoire à eux et vivent dans un objet MEMOBJ_CACHESTORESQLCP de 48 Ko qui appartient au store lui-même et que plusieurs stubs partagent.
Les 16 Ko d’une shell query sont une réservation par pages, mais quelle part est consommée à l’intérieur ? Sur un conteneur jetable SQL Server 2025 CU10 (17.0.5035.5, Linux), j’ai examiné les deux enveloppes des requêtes SELECT value FROM dbo.ShellProbe WHERE id=42 et id=43, qui partagent un plan Prepared. Chacune alloue une page pour MEMOBJ_COMPILE_ADHOC et une pour MEMOBJ_EXECUTE. La DMV sys.dm_os_memory_objects indique 8 192 octets par objet, mais son champ interne bytes_used vaut NULL dans cet essai. J’ai donc lu les registres de tailles et les pointeurs de l’allocateur en mémoire, en m’appuyant sur les symboles publics Microsoft.
Voici la répartition après les premières exécutions, en octets, identique pour les deux enveloppes :
| Objet | Allocations demandées | En-têtes et alignement | Espace encore disponible | Total |
|---|---|---|---|---|
| Compilation | 6 125 | 339 | 1 728 | 8 192 |
| Exécution | 5 544 | 184 | 2 464 | 8 192 |
| Ensemble | 11 669 | 523 | 4 192 | 16 384 |
L’allocateur consomme donc 74,4 % des deux pages ; 25,6 % restent disponibles dans ces pages. Les tailles demandées ne mesurent toutefois pas les seuls octets utiles : une structure peut contenir des champs inutilisés ou réserver de la capacité. Le plan préparé partagé, le cache des textes et les structures globales des stores ne sont pas compris dans ces 16 Ko. Ces chiffres concernent cette instruction et ce build, sans pression mémoire.
Le plan compilé et le contexte d’exécution
Une entrée de SQL Plans ou d’Object Plans contient un plan compilé et ses contextes d’exécution. Cette distinction explique la mémoire du cache, ses compteurs et ce qui se passe quand cent sessions exécutent la même procédure.
Le programme et ses exécutions
Le plan compilé (compiled plan) est l’équivalent d’un programme : la liste des opérateurs de chaque instruction du batch ou du module, la manière de les enchaîner, la liste des paramètres et la table des symboles (les variables déclarées, leur type). Il ne change pas d’une exécution à l’autre. Il ne contient ni les valeurs des paramètres de l’exécution en cours, ni l’état d’une exécution : seulement les valeurs qui ont servi à le compiler, visibles dans le plan XML (attribut ParameterCompiledValue). Il ne fixe pas non plus le degré de parallélisme, choisi à chaque exécution : un plan parallèle en cache peut s’exécuter en série.
Pour exécuter ce programme, il faut un espace de travail : les valeurs reçues pour les paramètres, celles des variables locales, l’instruction en cours, et, pour chaque opérateur du plan, son état du moment (la position d’un parcours d’index, les lignes déjà lues, la table de hachage en construction). C’est le contexte d’exécution (execution context, MXC dans les sources internes). La documentation le définit comme la structure de données « qui contient les données spécifiques à une exécution, comme les valeurs des paramètres ».
SQL Server reprend ici une séparation classique, celle du code réentrant et de l’enregistrement d’activation (activation record). Quand Edsger Dijkstra a décrit en 1960 la mise en œuvre des procédures récursives d’Algol (Recursive Programming, Numerische Mathematik, vol. 2), il a séparé le code de la procédure, unique et jamais modifié, de l’enregistrement que reçoit chaque appel sur la pile, avec ses paramètres et ses variables locales. Un code qui ne modifie jamais ses propres instructions et range tout son état dans l’enregistrement de l’appel est dit réentrant : un nombre quelconque d’appels peuvent l’exécuter en même temps. Le plan compilé est réentrant au même sens : un nombre quelconque de sessions l’utilisent en même temps. Le contexte d’exécution est l’enregistrement d’activation d’une exécution : il ne sert qu’à une session à la fois.
Une différence avec la pile d’un programme : un enregistrement d’activation est détruit au retour de l’appel, alors qu’un contexte d’exécution est gardé. À la fin d’une exécution, le moteur ne libère pas le contexte, il le remet dans une liste de contextes libres attachée au plan compilé. L’exécution suivante prend un contexte dans cette liste au lieu d’en construire un. C’est une réserve d’objets (object pool), le procédé classique quand un objet coûte cher à construire et peu à garder : un contexte se reconstruit en quelques dizaines de kilo-octets d’allocations, mais autant les éviter à chaque appel.
Les contextes n’apparaissent pas dans sys.dm_exec_cached_plans, qui ne montre que l’entrée. On les voit dans sys.dm_exec_cached_plan_dependent_objects, une ligne de type Executable Plan par contexte, et on les compte par trois attributs de sys.dm_exec_plan_attributes :
misses_exec_context: nombre de fois qu’une exécution n’a trouvé aucun contexte libre et a dû en construire un ;hits_exec_context: nombre de fois qu’une exécution a repris un contexte libre ;free_exec_context: nombre de contextes libres au moment de la lecture.
SELECT a.attribute, a.value
FROM sys.dm_exec_cached_plans AS p
CROSS APPLY sys.dm_exec_sql_text(p.plan_handle) AS t
CROSS APPLY sys.dm_exec_plan_attributes(p.plan_handle) AS a
WHERE t.objectid = OBJECT_ID(N'PachaDataFormation.Contact.GetContactParNom')
  AND a.attribute LIKE N'%exec_context%';

SELECT d.cacheobjtype, d.usecounts, d.memory_object_address
FROM sys.dm_exec_cached_plans AS p
CROSS APPLY sys.dm_exec_sql_text(p.plan_handle) AS t
CROSS APPLY sys.dm_exec_cached_plan_dependent_objects(p.plan_handle) AS d
WHERE t.objectid = OBJECT_ID(N'PachaDataFormation.Contact.GetContactParNom');
Un exemple pas à pas
Pour voir les contextes naître et resservir, j’ai écrit une procédure qui attend six secondes puis fait une jointure de deux tables, et je l’ai lancée dans quatre sessions en même temps, puis, une fois les quatre terminées, dans deux.
CREATE OR ALTER PROCEDURE dbo.pB1 AS
BEGIN
    WAITFOR DELAY '00:00:06';
    SELECT COUNT(*) AS n FROM dbo.J1 AS j JOIN dbo.J2 AS k ON k.id = j.fk WHERE j.v = 3;
END;
| Moment | free | misses | hits | Contextes (Executable Plan) | Ce qui s’est passé |
|---|---|---|---|---|---|
| avant | 0 | la procédure n’est pas en cache | |||
| pendant la vague de quatre sessions | 0 | 4 | 0 | 4 | aucun contexte libre : chaque session en construit un |
| après la vague | 4 | 4 | 0 | 4 | les quatre contextes sont remis dans la liste des libres |
| pendant la vague de deux sessions | 2 | 4 | 2 | 4 | chaque session prend un contexte libre, aucun n’est construit |
| après | 4 | 4 | 2 | 4 | les quatre contextes sont toujours là |
Les adresses mémoire des quatre contextes sont restées les mêmes du début à la fin : la vague de deux a repris deux des quatre contextes existants. Le nombre de contextes gardés suit donc le pic de concurrence, quatre ici, et ne redescend pas quand la concurrence baisse. La mémoire non plus : pour cette jointure de deux tables, un contexte occupe 48 Ko (8 Ko de MEMOBJ_EXECUTE construits à l’entrée dans la procédure, puis 16 Ko de MEMOBJ_XSTMT et 24 Ko de MEMOBJ_QUERYEXECCNTXTFORSE quand le SELECT s’exécute), contre 32 Ko pour le plan compilé. Avec quatre contextes, l’entrée passe à 224 Ko, dont 192 Ko de contextes. Une procédure appelée par cent sessions à la fois garde cent contextes.
Un détail sur usecounts, qui compte les recherches réussies et non les exécutions. Si la procédure n’est pas en cache au moment de la vague, une seule session la compile ; les trois autres attendent la fin de cette compilation (voir « La recherche d’un plan ») et reçoivent le plan sans passer par une recherche réussie. Dans l’exemple ci-dessus, usecounts valait 1 après la vague de quatre, et 3 après celle de deux. Sur une procédure exécutée une fois avant la vague, il passe de 1 à 5.
La destruction d’un contexte
Le livre blanc Plan Caching and Recompilation in SQL Server 2012 de Greg Low dit qu’une erreur de gravité 11 ou plus détruit le contexte au lieu de le remettre dans la liste des libres. La mesure dit autre chose. J’ai exécuté trois fois de suite des procédures qui font une jointure, puis une instruction en erreur, puis un SELECT :
| Instruction | Erreur | free | misses | hits | Contexte |
|---|---|---|---|---|---|
SELECT 2 | aucune | 1 | 1 | 2 | réutilisé |
RAISERROR('x', 10, 1) | message de gravité 10 | 1 | 1 | 2 | réutilisé |
RAISERROR('x', 16, 1) | gravité 16 | 1 | 1 | 2 | réutilisé |
SELECT 1 / @z avec @z = 0 | 8134, gravité 16 | 0 | 3 | 0 | détruit à chaque fois |
THROW 50001, 'x', 1 | gravité 16 | 0 | 3 | 0 | détruit |
| doublon de clé primaire | 2627, gravité 14 | 0 | 3 | 0 | détruit |
SELECT 1 / @z dans un TRY, capturée par CATCH | aucune côté client | 0 | 3 | 0 | détruit |
RAISERROR('x', 16, 1) dans un TRY | aucune côté client | 0 | 3 | 0 | détruit |
La gravité ne suffit donc pas à prédire la destruction du contexte. Un RAISERROR hors d’un bloc TRY, même de gravité 16, n’interrompt pas l’exécution : c’est un message envoyé au client, et l’exécution continue. Une exception interrompt l’exécution en cours : erreur levée par le moteur, THROW, ou toute erreur qui fait passer dans un CATCH, même capturée, même de gravité 14. Le contexte interrompu n’est pas remis dans la liste, sans doute parce que l’état de ses opérateurs n’est plus garanti cohérent ; c’est une inférence, la cause n’est pas publiée. La conséquence pratique est mesurable : une procédure qui passe par son CATCH à chaque appel, parce qu’elle utilise une erreur attendue comme flux normal, reconstruit son contexte à chaque exécution.
Greg Low écrit aussi que les contextes des sections parallèles d’un plan ne sont pas mis en cache, alors que ceux des sections série le sont. Un plan parallèle est découpé en sections, délimitées par les opérateurs d’échange (Parallelism) : la section qui produit le résultat final s’exécute sur le thread de la session, les autres sur autant de threads supplémentaires que le degré de parallélisme. Chaque thread a besoin de son propre état d’opérateurs.
J’ai observé une procédure parallèle de degré 4, qui occupait 12 threads de travail, avant, pendant et après son exécution. Chaque session a un seul contexte (Executable Plan), quel que soit le nombre de threads. Mais l’objet MEMOBJ_EXECUTE de ce contexte passe de 16 Ko à 72 Ko pendant l’exécution, puis revient à 16 Ko à la fin : ces 56 Ko, construits à chaque exécution et rendus à la fin, sont selon toute vraisemblance l’état des sections parallèles. Seule la partie série reste en cache, ce qui va dans le sens de la phrase de Low. Avec OPTION (MAXDOP 1), le contexte a dès la première exécution sa taille définitive. Un plan parallèle coûte donc à chaque exécution la construction de ses sections parallèles, même quand son contexte est réutilisé.
Sous pression mémoire
D’après Sangeetha Shekar, de l’équipe de programmabilité de SQL Server, dans le billet 9.0 Memory Pressure Limits du 16 janvier 2007, le moteur peut aussi, sous pression mémoire, récupérer jusqu’à la moitié de la mémoire des contextes d’un plan, même en cours d’utilisation : un contexte se reconstruit à peu de frais, un plan compilé non. Sur 2025, la mesure montre autre chose. J’ai suivi une entrée qui avait quatre contextes libres, sous la pression décrite plus loin : à la première vague de pression, les quatre contextes libres ont tous été libérés, et le plan compilé est resté. Un contexte en cours d’utilisation a gardé son objet MEMOBJ_EXECUTE et perdu son objet MEMOBJ_QUERYEXECCNTXTFORSE. Sous pression, le moteur rend donc d’abord la mémoire la moins chère à reconstruire.
La recherche d’un plan
SQL Server retrouve un plan de deux façons, selon l’origine du batch. Dans les deux cas, il calcule d’abord un numéro de bucket dans la table de hachage du store, puis parcourt la chaîne de ce bucket à la recherche d’une entrée dont la clé correspond : l’objet, la base, et une série d’attributs de la session, comme les options SET, qui forment la clé du cache, décrite plus loin.
Les modules, recherche par identifiant
Pour une procédure, une fonction ou un déclencheur, l’objet est connu par son object_id. La recherche se fait dans Object Plans avec cet identifiant, la base, et les attributs de la session. Si aucun plan ne convient, le moteur compile, et il le fait sous un verrou exclusif sur la ressource COMPILE de l’objet. Ce verrou garantit qu’une procédure n’est compilée qu’une fois, même si cent sessions l’appellent au même moment alors qu’elle n’est pas en cache.
Sur 2025 CU10, huit sessions synchronisées ont appelé une procédure qui n’était pas en cache, et dont la compilation prenait environ une seconde (200 jointures). Une seule session a compilé et inséré le plan. Les sept autres ont attendu 988 ms chacune sur LCK_M_X, que sys.dm_os_waiting_tasks montrait ainsi :
session_id wait_type wait_duration_ms resource_description
54         LCK_M_X   302              objectlock objid=2101582525 subresource=COMPILE dbid=6 mode=X
57         LCK_M_X   300              objectlock objid=2101582525 subresource=COMPILE dbid=6 mode=X
...
L’objid de la ressource est l’object_id de la procédure. Une fois le verrou libéré, les sept sessions ont exécuté le plan de la première, sans le recompiler.
Le problème que ce verrou résout a un nom en génie logiciel : la ruée sur le cache (cache stampede, ou thundering herd). Quand une entrée coûteuse manque et que beaucoup de demandeurs arrivent en même temps, chacun constate l’absence et la recalcule, et le système fait n fois le même travail au pire moment. La parade classique est la coalescence des requêtes (request coalescing, le paquet singleflight de Go, golang.org/x/sync) : le premier demandeur calcule, les autres attendent son résultat. Le verrou COMPILE est exactement cela.
Les batchs, recherche par le texte
Pour un batch ad hoc ou préparé, il n’y a pas d’identifiant d’objet. Le moteur en fabrique un à partir du texte : un hachage de 32 bits du batch entier, qui sert d’objectid dans la clé et dans le plan_handle (voir « Les identifiants d’un plan »). Il cherche le texte dans le cache SQL Manager, puis, dans SQL Plans, une entrée de même objectid dont le texte et la clé correspondent. La correspondance est exacte, caractère par caractère : une espace, une majuscule ou un commentaire de plus font un autre texte, donc une autre entrée.
Sur ce chemin, il n’y a pas de verrou de compilation. Des sessions qui envoient le même batch au même moment, alors qu’il n’est pas en cache, le compilent chacune, et le cache garde chacune des compilations. Greg Low écrivait en 2012 qu’une seule des entrées reste en cache. Sur 2025 CU10, huit sessions synchronisées sur le même batch ad hoc ont laissé huit entrées du même texte, huit plan_handle différents, chacune avec usecounts à 1. Sept ne serviront plus jamais : l’exécution suivante retrouve l’une d’elles, et les autres attendent l’éviction. Huit sessions sur le même sp_executesql ont laissé de même huit entrées Prepared. C’est la ruée sur le cache, sans parade.
Le même texte produit bien le même objectid. Cet identifiant sert à retrouver les entrées candidates dans le cache ; il n’impose pas qu’une seule entrée puisse exister pour ce texte. La documentation de sys.dm_exec_plan_attributes le décrit comme une composante de la clé de recherche. D’autres attributs, comme la base et les options SET, complètent cette clé.
Même si le texte, la base et toutes les options sont identiques, deux sessions peuvent suivre cet enchaînement :
- La session A cherche le plan dans le cache. Il est absent : elle commence à compiler.
- Avant qu’A ait terminé et inséré son plan, la session B cherche le même plan. Elle constate elle aussi son absence et commence sa propre compilation.
- Chaque session termine sa compilation et insère sa propre entrée dans le cache.
Les deux entrées ont alors le même objectid et la même clé de recherche, mais correspondent à deux compilations et à deux allocations distinctes, chacune avec son propre plan_handle. L’objectid ne joue donc pas le rôle d’une contrainte d’unicité. Sans sérialisation des compilations, l’enchaînement « chercher, compiler, insérer » peut laisser plusieurs copies pour la même clé. La documentation de sp_executesql décrit explicitement ces copies lorsque OPTIMIZED_SP_EXECUTESQL est désactivé. C’est ce que montrent les huit compilations simultanées de l’essai ci-dessus.
SQL Server 2025 a ajouté la parade pour sp_executesql, et pour lui seul : l’option de base OPTIMIZED_SP_EXECUTESQL, désactivée par défaut.
USE PachaDataFormation;
ALTER DATABASE SCOPED CONFIGURATION SET OPTIMIZED_SP_EXECUTESQL = ON;
Avec l’option, les huit mêmes appels de sp_executesql ont laissé une seule entrée Prepared, avec usecounts à 8, et sept attentes LCK_M_X sur une ressource COMPILE. L’objid de cette ressource ne correspond à aucun objet de la base : c’est un identifiant tiré du texte, comme l’objectid des entrées Prepared. Un batch ad hoc n’en profite pas : huit entrées avec l’option comme sans elle. Je n’ai pas mesuré EXECUTE (@sql), mais sa chaîne est recherchée comme un batch ad hoc (voir plus bas).
Les instructions d’un batch
Un batch de plusieurs instructions a un seul texte, donc une seule entrée et un seul plan compilé, qui contient le plan de chaque instruction. Le moteur relève ensuite les statistiques d’exécution instruction par instruction, dans sys.dm_exec_query_stats, où chaque ligne est repérée par les positions de début et de fin de son instruction dans le texte du batch : statement_start_offset et statement_end_offset. Ces positions sont en octets, comptées à partir de 0, dans un texte nvarchar où chaque caractère occupe deux octets, accents compris. Pour retrouver la position d’un caractère, qui pour SUBSTRING compte à partir de 1, il faut donc diviser par deux et ajouter un.
Sur ce batch de trois instructions, envoyé tel quel :
-- Requête : élève, numéro d'été /*D1*/
SELECT COUNT(*) AS [élèves] FROM dbo.J1 j JOIN dbo.J2 k ON k.id = j.fk WHERE j.x <> 'é';
/* commentaire où l'on parle de café */ SELECT MAX(k.v) AS maxi FROM dbo.J2 k JOIN dbo.J3 m ON m.id = k.fk WHERE k.x <> 'à';
SELECT TOP (1) j.x FROM dbo.J1 j JOIN dbo.J3 m ON m.id = j.fk ORDER BY j.v DESC
sys.dm_exec_query_stats rend trois lignes, de positions 80 à 252, 338 à 502 et 508 à 664. Le premier SELECT commence au 41ᵉ caractère du texte : 80 / 2 + 1 = 41. statement_end_offset désigne le premier octet du dernier caractère de l’instruction : la première fait (252 - 80) / 2 + 1 = 87 caractères, le SELECT sans son point-virgule. Ni le commentaire de tête, ni le commentaire placé devant la deuxième instruction, ni les points-virgules n’appartiennent à une instruction. La requête qui extrait chaque instruction :
SELECT qs.statement_start_offset, qs.statement_end_offset, qs.execution_count,
       SUBSTRING(t.text, qs.statement_start_offset / 2 + 1,
                 (CASE qs.statement_end_offset
                      WHEN -1 THEN DATALENGTH(t.text)
                      ELSE qs.statement_end_offset
                  END - qs.statement_start_offset) / 2 + 1) AS instruction
FROM sys.dm_exec_query_stats AS qs
CROSS APPLY sys.dm_exec_sql_text(qs.sql_handle) AS t
ORDER BY qs.sql_handle, qs.statement_start_offset;
La documentation de sys.dm_exec_query_stats précise que, pour les versions antérieures à SQL Server 2014, statement_end_offset vaut -1 pour indiquer la fin du batch, d’où le CASE. La mesure sur 2025 CU10 est cohérente avec cette restriction : aucune des 192 lignes de sys.dm_exec_query_stats de l’instance de test ne valait -1 ; la dernière instruction avait sa position réelle. La valeur -1 apparaît dans sys.dm_exec_requests, pour la dernière instruction en cours d’un batch quand ce n’est pas une requête (un WAITFOR, par exemple). Le CASE reste donc utile pour sys.dm_exec_requests, et ne coûte rien ailleurs. Pour un module, les positions sont celles de l’instruction dans le texte du CREATE PROCEDURE.
Une recherche par niveau d’appel
La recherche se fait au moment où le code s’exécute, pour chaque niveau d’appel séparément. Prenons ce batch ad hoc, qui appelle une procédure, exécute une chaîne par EXEC et contient une requête que le moteur paramètre lui-même :
/*E-lot*/ EXEC dbo.pE 3;
EXEC (N'SELECT MAX(k.v) AS m FROM dbo.J2 k JOIN dbo.J3 m ON m.id = k.fk /*E-dyn*/');
SELECT v FROM dbo.T WHERE id = 2;
Une session d’événements étendus sur sp_cache_hit, sp_cache_insert et le début de chaque instruction donne, à la deuxième exécution du batch, cet ordre :
| Ordre | Événement | Objet |
|---|---|---|
| 1 | sp_cache_hit | le batch entier, ADHOC |
| 2 | début du batch | |
| 3 | début de EXEC dbo.pE 3 | |
| 4 | sp_cache_hit | la procédure pE, PROC, par son object_id |
| 5 | début de l’instruction de la procédure | |
| 6 | début de EXEC (N'...') | |
| 7 | sp_cache_hit | la chaîne dynamique, ADHOC, par son propre texte |
| 8 | début de l’instruction dynamique | |
| 9 | début du SELECT v FROM dbo.T | aucune recherche |
Le batch est recherché une fois, avant son exécution. La procédure et la chaîne dynamique le sont chacune quand leur instruction s’exécute, comme si elles avaient été envoyées seules : une procédure appelée dix fois dans une boucle est recherchée dix fois. La requête paramétrée, elle, n’a été recherchée qu’une fois, à la compilation du batch : le plan du batch garde un lien direct vers son plan préparé, qui a gardé usecounts à 1 alors que l’instruction comptait deux exécutions. Le cache laisse ainsi quatre entrées : le batch, la procédure, la chaîne dynamique et le plan préparé.
Une remarque sur l’instrument : sp_cache_miss ne s’est jamais déclenché avant l’insertion d’un plan qu’on pouvait mettre en cache, seulement pour les batchs non mis en cache et pour les sessions qui attendaient un verrou de compilation. On ne mesure donc pas le taux d’échec du cache en comptant cet événement.
Les identifiants d’un plan
Quatre identifiants servent à relier les vues du cache entre elles.
| Identifiant | Calculé sur | Sert à |
|---|---|---|
sql_handle | le texte du batch entier, ou l’identité du module | retrouver le texte, par sys.dm_exec_sql_text |
plan_handle | l’entrée de cache du batch | retrouver le plan, par sys.dm_exec_query_plan, et le retirer par DBCC FREEPROCCACHE |
query_hash | l’arbre logique d’une instruction | regrouper les instructions qui ne diffèrent que par leurs littéraux |
query_plan_hash | l’arbre physique du plan d’une instruction | regrouper les instructions qui ont le même plan |
Le sql_handle et le plan_handle
Un sql_handle peut correspondre à plusieurs plan_handle : le même texte compilé sous deux jeux d’options SET, ou dans deux bases, donne deux entrées. Le plan_handle ne change pas quand une instruction du batch est recompilée. Il est unique parmi les plans présents, mais peut resservir plus tard pour un autre plan.
Aucun des deux formats n’est documenté. Mais on peut les décoder.
Les colonnes sont déclarées varbinary(64), un type de longueur variable pouvant contenir jusqu’à 64 octets. Les deux handles mesurés sur 2025 font 44 octets, sous Linux comme sous Windows. Le schéma ci-dessous en donne trois exemples relevés sur 2025 CU10 : le plan_handle et le sql_handle d’une jointure ad hoc exécutée dans la base 6, et le sql_handle d’une procédure. Les nombres y sont écrits octet de poids faible en tête (little-endian), comme en mémoire sur x64 : 0600 est la base 6, DB9B4319 se lit 0x19439BDB.
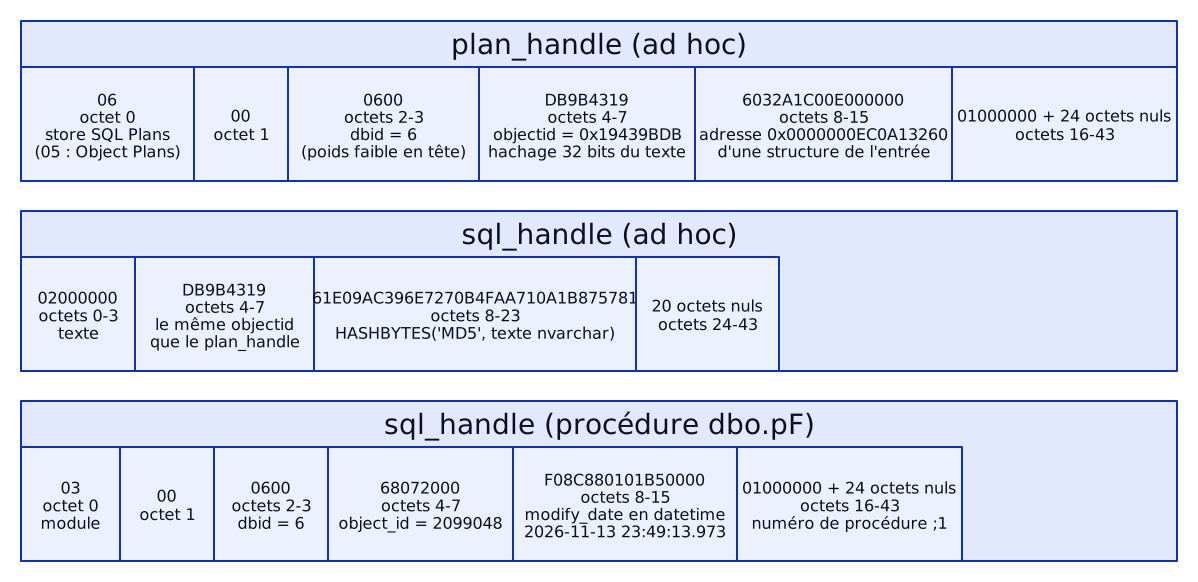
Ce que l’on y lit :
- l’octet 0 du
plan_handledésigne le store :06pour SQL Plans (Adhoc,Prepared),05pour Object Plans (procédures, fonctions, déclencheurs) ; - les octets 2 et 3 donnent la base, les octets 4 à 7 l’attribut
objectidde la clé : l’object_idd’un module, ou, pour un batch, un hachage de 32 bits de son texte. Ce hachage n’est niCHECKSUM, niBINARY_CHECKSUM, ni le début du MD5 du texte : sa fonction n’est pas identifiée ; - les octets 8 à 15 sont une adresse mémoire, voisine de l’entrée de
sys.dm_os_memory_cache_entries(le plus souvent 0x830 octets avant elle), sans être nimemory_object_addressni l’adresse de l’entrée. C’est elle qui distingue deux entrées du même texte sous deux jeux d’options : ces deuxplan_handlene diffèrent que par ces huit octets. C’est aussi elle qui explique qu’unplan_handlepuisse resservir. Dans un essai, l’ancien plan d’une procédure numérotéedbo.pG;1, invalidé, a laissé sonplan_handleexact au nouveau plan dedbo.pG;2, de mêmeobjectid, alloué à la même adresse ; - le
sql_handled’un batch contient, après02000000, le mêmeobjectid, puis exactement le résultat deHASHBYTES('MD5', texte)sur le texte ennvarchar, tel que le rendsys.dm_exec_sql_text. Il ne dépend que du texte : ni de la base, ni des optionsSET; - le
sql_handled’un module commence par03, puis contient la base, l’object_id, la date de dernière modification du module (modify_datedesys.objects, au format binaire dedatetime) et le numéro de la procédure dans son groupe (;1). UnALTER PROCEDUREchange donc lesql_handle, ce qui sépare les statistiques des deux versions.
Le MD5 se vérifie sur n’importe quelle instance :
SELECT TOP (10)
       CONVERT(varchar(100), qs.sql_handle, 1) AS sql_handle,
       CONVERT(varchar(40), HASHBYTES('MD5', t.text), 1) AS md5_du_texte
FROM sys.dm_exec_query_stats AS qs
CROSS APPLY sys.dm_exec_sql_text(qs.sql_handle) AS t
WHERE qs.sql_handle >= 0x02 AND qs.sql_handle < 0x03;
Les octets 8 à 23 de la première colonne (en comptant à partir de 0, comme dans le schéma) sont égaux à la seconde.
L’objectid et la base servent aussi à placer l’entrée dans la table de hachage. Sur 36 entrées sur 36, dont des procédures et un déclencheur, bucketid valait ((objectid × dbid) mod 2³²) mod 40 009 : le produit est calculé sur un entier de 32 bits non signé, qui déborde, puis réduit au nombre de buckets. Pour la jointure du schéma, (423 861 211 × 6) mod 2³² mod 40 009 = 35 190. Le même texte dans deux bases tombe donc dans deux buckets, alors que sous deux jeux d’options il tombe dans le même, où la recherche compare ensuite les attributs de la clé.
Le query_hash et le hachage de Zobrist
query_hash et query_plan_hash sont apparus avec SQL Server 2008. Bart Duncan, de Microsoft, les a présentés la même année comme des empreintes dans son billet Query Fingerprints and Plan Fingerprints : elles ignorent espaces, commentaires et littéraux, ne dépendent ni de la base ni de l’instance, et des collisions sont possibles. Trois textes qui ne diffèrent que par un littéral donnent ainsi trois entrées, trois sql_handle, et un seul query_hash :
| Littéral | sql_handle (début) | query_hash | query_plan_hash |
|---|---|---|---|
| 42 | 0x02000000EBE0B80E | 0x72E9689BB8C07D61 | 0x2AAACFCC4662E420 |
| 43 | 0x0200000007CED70E | 0x72E9689BB8C07D61 | 0x2AAACFCC4662E420 |
| 1 | 0x0200000077BF3138 | 0x72E9689BB8C07D61 | 0x2AAACFCC4662E420 |
La documentation de sys.query_store_query définit query_hash comme un hachage de Zobrist calculé sur l’arbre logique lié (bound logical query tree), l’arbre que produit l’analyse de la requête une fois les noms résolus, avant l’optimisation. Albert Zobrist l’a inventé en 1970 pour les programmes d’échecs (A New Hashing Method with Application for Game Playing, rapport technique 88, université du Wisconsin). Un programme d’échecs rencontre la même position par des chemins différents et veut la reconnaître sans la comparer pièce par pièce. Zobrist tire au hasard, une fois pour toutes, un nombre de 64 bits pour chaque couple (pièce, case) : 12 sortes de pièces sur 64 cases, 768 nombres. Le hachage d’une position est le OU exclusif (XOR, noté ⊕) des nombres des pièces présentes :
h(position) = R[cavalier blanc, g1] ⊕ R[roi blanc, e1] ⊕ … ⊕ R[roi noir, e8]
Le XOR a deux propriétés qui font tout l’intérêt de la méthode. Il est commutatif, donc le hachage ne dépend pas de l’ordre dans lequel on parcourt les pièces. Et chaque nombre est son propre inverse (x ⊕ x = 0), donc jouer Cg1-f3 se répercute par deux XOR, sans tout recalculer : h’ = h ⊕ R[cavalier blanc, g1] ⊕ R[cavalier blanc, f3]. Les nombres étant aléatoires, deux positions différentes n’ont la même valeur qu’avec une probabilité d’environ 2⁻⁶⁴.
Microsoft ne publie ni ce qui joue le rôle de la pièce et de la case dans un arbre de requête, ni la table des nombres. La structure se voit pourtant de l’extérieur, parce qu’un hachage de Zobrist a une propriété mesurable : il est linéaire pour le XOR. Si changer un élément de la requête revient à retirer un nombre et à en ajouter un autre, l’écart entre les deux hachages (leur XOR) ne dépend que de l’élément changé, et pas du reste de la requête. Les hachages se lisent sans exécuter la requête, dans le plan estimé (SET SHOWPLAN_XML ON, attribut QueryHash de l’élément StmtSimple). Sur une table dbo.Z (a, b, c, d), sur 2025 CU10 :
| Requête | query_hash |
|---|---|
SELECT a FROM dbo.Z WHERE b = 1 | 0x7999CB2843E0BFA1 |
SELECT a FROM dbo.Z WHERE c = 1 | 0xA9FF2C4E40ED72CA |
SELECT d FROM dbo.Z WHERE b = 1 | 0x0FAE3912CBD0ECBF |
SELECT d FROM dbo.Z WHERE c = 1 | 0xDFC8DE74C8DD21D4 |
Remplacer b par c dans le prédicat donne le même écart, que la colonne projetée soit a ou d :
0x7999CB2843E0BFA1 ⊕ 0xA9FF2C4E40ED72CA = 0x0FAE3912CBD0ECBF ⊕ 0xDFC8DE74C8DD21D4 = 0xD066E766030DCD6B
On peut donc prédire le hachage de la quatrième requête sans le demander au moteur : 0x0FAE3912CBD0ECBF ⊕ 0xD066E766030DCD6B = 0xDFC8DE74C8DD21D4. Une fonction de hachage ordinaire (MD5, ou un hachage polynomial du texte) n’aurait aucune raison de donner deux fois le même écart. Dix vérifications sur douze ont donné le même écart : changer la colonne projetée, la colonne du prédicat, l’opérateur (= contre >), la table de la colonne projetée, ou ajouter un prédicat, ajoute toujours la même quantité par XOR. C’est la signature d’un hachage de Zobrist. Les deux autres sont les exceptions décrites au paragraphe suivant : la contribution d’une colonne de prédicat dépend de la table, et deux prédicats joints par AND ne se déduisent pas des requêtes à un prédicat, parce que le AND change leur place dans l’arbre.
Reste la « case ». Aux échecs, la même pièce n’a pas la même valeur en g1 et en f3. Dans query_hash, la même colonne n’apporte pas la même contribution en première et en deuxième position de la liste SELECT. Le modèle h = B ⊕ P₁(x) ⊕ P₂(y), où P₁ et P₂ sont les contributions d’une colonne à chaque position, prédit exactement les hachages des permutations : h(SELECT d, a) = h(SELECT a, a) ⊕ h(SELECT a, d) ⊕ h(SELECT d, d), vérifié sur quatre combinaisons. La position fait donc partie de la case, et c’est pour cela que l’ordre compte partout : WHERE b = 1 AND c = 2 et WHERE c = 2 AND b = 1, SELECT a, d et SELECT d, a, Z JOIN Y et Y JOIN Z, y.b = z.b et z.b = y.b, b = 1 et 1 = b ont chacun deux query_hash différents. Deux requêtes équivalentes écrites différemment ne se regroupent pas. Un détail montre que la case n’est pas seulement un rang : l’écart dû à la colonne d’un prédicat n’est pas le même dans deux tables différentes, alors que celui d’une colonne projetée l’est. Le « lieu » d’un nœud inclut donc au moins une partie de son contexte dans l’arbre ; je n’ai pas établi s’il s’agit de son chemin complet depuis la racine.
Ce qui entre dans la pièce se lit par les mêmes essais :
Ignoré par query_hash | Compté |
|---|---|
| espaces, commentaires, casse, crochets | le nom de la table (Z contre Z2, même structure) |
l’alias d’une colonne de sortie (a AS x) | le nom du schéma (dbo.T, s1.T, s2.T) |
dbo.Z contre Z quand c’est la même table | le nom des colonnes (b contre c, même type) |
la valeur et le type d’un littéral (1, 1000000, 'x', N'x', 1.5) | le nom d’un alias de table (t contre u) |
| une variable à la place d’un littéral, et son type | une conversion explicite (CAST(1 AS bigint)) |
la valeur de TOP | le nombre d’éléments d’une liste IN |
l’object_id de la table, le column_id et le type des colonnes | tout indicateur écrit dans le texte, et sa valeur |
Le hachage est calculé sur les noms, pas sur les identifiants du catalogue. Dans deux bases où la même table dbo.Z a deux object_id différents, et même après l’avoir recréée avec ses colonnes dans un autre ordre ou une colonne en bigint, le query_hash est resté 0x7999CB2843E0BFA1. C’est ce qui permet de comparer des query_hash d’une base ou d’une instance à l’autre. Les littéraux sont remplacés par un marqueur neutre, sans leur type ; leur valeur n’entre jamais dans le hachage.
Le hachage dans le code du moteur
Le débogueur confirme la mesure. Les symboles publics de sqllang.dll contiennent une classe CFingerprintUtilStatic, dont le membre m_randomTable est un tableau de 31 × 256 entiers de 64 bits, tous distincts et non nuls (les premiers valent 0xA3AFCDBDC442EBF3, 0xB577B9B52AF851A3, 0xCA68ED0953AD020F), et des fonctions ZobristHashBytes, ZobristHashForBool et ZobristHashForNULL. La table a une valeur aléatoire par couple (position d’un octet, valeur de cet octet) : c’est la table de Zobrist, appliquée non à des pièces sur des cases mais aux octets d’une chaîne, un nom de colonne par exemple. C’est pour cela que les noms comptent et pas les identifiants.
Pendant la première compilation d’une jointure, gdb a compté 73 appels de ZobristHashBytes, 58 de ZobristHashForBool et 47 de ZobristHashForNULL, venus de CFingerprintUtilEx::GenFingerprint, appelée par PqoBuild, la fonction qui construit l’entrée de l’optimiseur ; chaque opérateur logique y ajoute sa contribution par une méthode ComputeHashsum (ici celle de l’agrégat, CLogOp_GbAgg). À la réutilisation du plan, aucune de ces fonctions n’a été appelée : le query_hash est calculé à la compilation et gardé avec le plan, ce qui confirme qu’il ne sert pas à la recherche.
Le procédé a un nom en théorie du hachage : le hachage par tabulation (tabulation hashing). On découpe la clé en caractères, on lit pour chaque caractère et chaque position une valeur aléatoire dans une table, et on combine par XOR. Zobrist l’avait inventé pour les échecs ; J. Lawrence Carter et Mark Wegman l’ont étudié comme famille de hachage universel dès 1977 (STOC, publié en revue en 1979), et Mihai Pătrașcu et Mikkel Thorup ont montré en 2011 (The Power of Simple Tabulation Hashing, STOC) que cette forme simple se comporte, pour la plupart des usages, presque aussi bien qu’un hachage idéal, pour le prix de quelques lectures de table. Pour un moteur qui calcule une empreinte à chaque compilation, c’est le bon compromis : rapide, et combinable nœud par nœud.
ComputeWstrCrc calcule un CRC sur une chaîne Unicode avec la table du CRC-32 (elle commence par 0x00000000, 0x77073096, 0xEE0E612C, celle du polynôme 0xEDB88320). Parmi les fonctions de hachage suivies, elle est la seule appelée aussi souvent à la réutilisation qu’à la compilation : elle pourrait servir à la recherche. Je n’ai pas établi qu’elle produit l’objectid d’un batch : le CRC-32 du texte entier ne correspond pas, et la fonction ne lit que des tranches de seize caractères.
Les indicateurs et le query_hash
La page de sys.query_store_query dit que les indicateurs de requête n’entrent pas dans le hachage. La mesure distingue deux sortes d’indicateurs. Ceux qu’on écrit dans le texte de la requête, clause OPTION ou indicateur de table, font partie de l’arbre logique et changent le query_hash, valeur comprise :
| Requête | query_hash |
|---|---|
SELECT a FROM dbo.Z WHERE b = 1 | 0x7999CB2843E0BFA1 |
même requête avec OPTION (MAXDOP 1) | 0x1C7CC80AC7AECA90 |
avec OPTION (MAXDOP 2) | 0xFA119C4795B4AF7E |
avec OPTION (RECOMPILE) | 0x227116E0CA973356 |
avec WITH (NOLOCK) | 0x881E58708A60CB0F |
Ceux que le Query Store pose sur une requête existante, par sys.sp_query_store_set_hints, ne le changent pas. J’ai posé OPTION (MAXDOP 1) par cette procédure sur une jointure de query_hash 0x3765C48B49EA3AD0 : la requête a été recompilée, son plan contient l’attribut QueryStoreStatementHintId, et son query_hash est resté le même dans sys.query_store_query, dans sys.dm_exec_query_stats et dans le plan XML. La phrase de la documentation vaut donc pour les indicateurs du Query Store, pas pour ceux du texte. Conséquence pratique : ajouter OPTION (RECOMPILE) dans le code d’une application crée une nouvelle requête pour le Query Store, avec un nouvel historique, alors que le même indicateur posé par le Query Store garde l’historique.
Kendra Little a montré en 2024, sur 2022 CU15, qu’après un plan forcé le query_hash d’une requête du Query Store pouvait prendre la valeur de son query_plan_hash. Je ne l’ai pas reproduit : sur 2025 CU10, une requête paramétrée avec deux plans, dont l’un forcé, a gardé son query_hash partout (Query Store, sys.dm_exec_query_stats, plan XML), et seul query_plan_hash a pris la valeur du plan forcé. Un seul scénario ne réfute pas son observation, qui vient peut-être d’un autre chemin (correction automatique des plans, autre build).
Le query_hash et la recherche d’un plan
La recherche décrite plus haut passe par le texte exact du batch (son objectid haché, puis le texte) ou par l’object_id du module. Dans SQL Server Execution Plans, 3e édition (Redgate, 2018, p. 36, « Criteria for plan reuse »), Grant Fritchey décrit une recherche par QueryHash, suivie d’une comparaison du texte exact, des options SET et de la base. Les trois requêtes du tableau des littéraux ont le même query_hash et des entrées distinctes, mais ce constat ne réfute pas son explication : la comparaison du texte qu’il décrit suffirait à les séparer.
Pour chercher un plan à partir de son query_hash, il faudrait connaître ce hash avant de retrouver le plan. Or, dans l’essai au débogueur sur 2025 CU10, les fonctions qui le calculent ont été appelées lors de la première compilation, puis plus du tout lorsque le moteur a retrouvé et réutilisé ce plan. L’essai montre donc une réutilisation sans nouveau calcul du query_hash par ces fonctions. Il ne suffit pas à décrire tous les chemins de recherche, ni à conclure sur les versions couvertes par le livre de 2018.
L’usage du query_hash pour le diagnostic est distinct : une fois les plans compilés, on peut lire leurs empreintes dans sys.dm_exec_query_stats et regrouper les instructions de même forme logique, même si leurs textes et leurs entrées de cache diffèrent :
SELECT qs.query_hash,
       COUNT(DISTINCT qs.plan_handle) AS nb_entrees,
       SUM(qs.execution_count) AS executions,
       SUM(qs.total_worker_time) / 1000 AS cpu_ms,
       MIN(SUBSTRING(t.text, qs.statement_start_offset / 2 + 1, 200)) AS exemple
FROM sys.dm_exec_query_stats AS qs
CROSS APPLY sys.dm_exec_sql_text(qs.sql_handle) AS t
GROUP BY qs.query_hash
HAVING COUNT(DISTINCT qs.plan_handle) > 1
ORDER BY nb_entrees DESC;
Une ligne avec des centaines d’entrées pour un seul query_hash désigne une requête que l’application envoie avec ses valeurs dans le texte, et qui mériterait d’être paramétrée.
La clé du cache
Un cache est pratiquement toujours un tableau associatif (un dictionnaire) : on y range une valeur sous une clé, et on la retrouve en présentant la même clé. La clé du cache (cache key) est l’ensemble des informations que l’application compare pour trouver une valeur dans le cache. Le terme est général : la norme HTTP (RFC 9111, HTTP Caching, section 2, 2022) définit la « clé du cache » d’une réponse comme, au minimum, la méthode et l’URL de la requête.
Le principe qui fixe ce qu’il faut mettre dans la clé vient de la mémoïsation, que Donald Michie a nommée en 1968 (Memo functions and machine learning, Nature, vol. 218) : on peut garder le résultat d’une fonction et le resservir sans la recalculer, à condition que la clé contienne toutes les entrées dont ce résultat dépend. Un plan est le résultat d’une fonction, la compilation, dont les entrées sont le texte, mais aussi tout ce qui change le sens de ce texte ou le plan qu’on en tire : la base de contexte, les options SET, la langue, le niveau de compatibilité, le schéma qui sert à résoudre un nom.
Deux erreurs sont possibles.
- Oublier une entrée dans la clé fait resservir un plan faux : un plan compilé pour
s1.Tservirait à un utilisateur qui doit lires2.T. - Y mettre une entrée qui ne change pas le résultat crée des doublons inutiles : c’est le cas d’
ARITHABORT, décrit plus loin.
HTTP a le même problème et la même solution : l’en-tête Vary d’une réponse ajoute à la clé les en-têtes de la requête dont la réponse dépend (la langue, l’encodage), exactement comme set_options ajoute les options de la session.
Un même texte peut donc avoir plusieurs plans en cache, un par combinaison d’attributs. Ces attributs se trouvent dans sys.dm_exec_plan_attributes, avec la colonne is_cache_key :
SELECT a.attribute, a.value
FROM sys.dm_exec_cached_plans AS p
CROSS APPLY sys.dm_exec_plan_attributes(p.plan_handle) AS a
WHERE p.plan_handle = (SELECT TOP (1) plan_handle FROM sys.dm_exec_cached_plans)
  AND a.is_cache_key = 1;
Sur 2025 CU10, dix-huit attributs ont is_cache_key à 1 : acceptable_cursor_options, compat_level, date_first, date_format, dbid, dbid_execute, is_replication_specific, language_id, merge_action_type, objectid, optional_clr_trigger_dbid, optional_clr_trigger_objid, optional_spid, parent_plan_handle, required_cursor_options, set_options, status, user_id.
Kalen Delaney en comptait dix-sept pour SQL Server 2012 dans Microsoft SQL Server 2012 Internals (Microsoft Press, 2013, chapitre 12 « Plan caching and recompilation », section « Cache stores », tableau 12-1), sans parent_plan_handle. La documentation de sys.dm_exec_plan_attributes le dit pour objectid, status et optional_spid, sans donner la liste complète.
Les plus fréquents en pratique :
set_options, un champ de bits des optionsSETde la session à la compilation ;user_id, le schéma par défaut quand le batch contient un nom d’objet non qualifié ;dbid, la base de contexte, celle duUSE, et non celle des objets cités ;language_id,date_formatetdate_first, la langue et les réglages de date ;compat_level, le niveau de compatibilité de la base de contexte pour un batch, de la base de création pour un module ;optional_spid, la session, quand une procédure utilise une table temporaire qu’elle n’a pas créée : une entrée par session.
Les options SET
J’ai exécuté le même texte, SELECT MAX(v) AS m FROM T;, dans la même session, sous huit contextes. Il a laissé huit entrées, avec un seul sql_handle :
| Contexte | set_options | user_id | date_format | language_id | date_first |
|---|---|---|---|---|---|
sqlcmd par défaut, sa | 251 | 1 | 1 | 0 | 7 |
ANSI_NULLS OFF | 219 | 1 | 1 | 0 | 7 |
QUOTED_IDENTIFIER OFF | 187 | 1 | 1 | 0 | 7 |
ARITHABORT ON | 4 347 | 1 | 1 | 0 | 7 |
DATEFORMAT dmy | 251 | 1 | 2 | 0 | 7 |
LANGUAGE French | 251 | 1 | 2 | 2 | 1 |
utilisateur de schéma par défaut s1 | 251 | 5 | 1 | 0 | 7 |
utilisateur de schéma par défaut s2 | 251 | 6 | 1 | 0 | 7 |
Les écarts de set_options se lisent bit à bit, avec la table de la page sys.dm_exec_plan_attributes : 32 pour ANSI_NULLS, 64 pour QUOTED_IDENTIFIER, 4 096 pour ARITHABORT. LANGUAGE French change aussi date_format, qui passe à 2 (dmy), et date_first, qui passe à 1 (lundi). Les options qui changent la clé, d’après le guide d’architecture du traitement des requêtes, sont ANSI_DEFAULTS, ANSI_NULL_DFLT_OFF, ANSI_NULL_DFLT_ON, ANSI_NULLS, ANSI_PADDING, ANSI_WARNINGS, ARITHABORT, CONCAT_NULL_YIELDS_NULL, DATEFIRST, DATEFORMAT, FORCEPLAN, LANGUAGE, NO_BROWSETABLE, NUMERIC_ROUNDABORT et QUOTED_IDENTIFIER. XACT_ABORT n’en fait pas partie.
En pratique, l’option qui dédouble le plus souvent les plans est ARITHABORT. SSMS ouvre ses sessions avec ARITHABORT ON, la plupart des pilotes avec OFF. Tant qu’ANSI_WARNINGS est à ON, ARITHABORT n’a aucun effet sur le résultat, mais il reste dans la clé : la requête copiée de l’application vers SSMS ne retrouve pas le plan de l’application, elle en compile un autre, avec les valeurs de paramètres du moment. C’est la cause la plus fréquente du « lent dans l’application, rapide dans SSMS » qu’Erland Sommarskog a décrit dans son article Slow in the Application, Fast in SSMS?.
Sur PachaDataFormation :
USE PachaDataFormation;
GO
SET ARITHABORT OFF;
GO
SELECT COUNT(*) FROM Contact.Contact AS c JOIN Contact.Societe AS s ON s.SocieteId = c.SocieteId;
GO
SET ARITHABORT ON;
GO
SELECT COUNT(*) FROM Contact.Contact AS c JOIN Contact.Societe AS s ON s.SocieteId = c.SocieteId;
GO
SELECT p.plan_handle, p.usecounts, a.value AS set_options
FROM sys.dm_exec_cached_plans AS p
CROSS APPLY sys.dm_exec_sql_text(p.plan_handle) AS t
CROSS APPLY sys.dm_exec_plan_attributes(p.plan_handle) AS a
WHERE t.text LIKE N'SELECT COUNT(*) FROM Contact.Contact AS c JOIN%'
  AND a.attribute = N'set_options';
Dans la version ODBC de sqlcmd utilisée ici, l’option -I ouvre la connexion avec QUOTED_IDENTIFIER ON : les guillemets doubles délimitent alors des noms d’objets, par exemple "MaTable", et les chaînes de caractères s’écrivent entre apostrophes. La dernière requête rend deux lignes, deux plan_handle, set_options 251 et 4 347 sous sqlcmd -I (davantage si d’autres sessions ont exécuté le même texte sous d’autres options). Sans -I, ce client ouvre sa session avec QUOTED_IDENTIFIER OFF, et les deux valeurs deviennent 187 et 4 283 : le client choisit les options, donc la clé.
Pour une procédure, ANSI_NULLS et QUOTED_IDENTIFIER sont enregistrées avec l’objet à sa création : elles ne dédoublent pas son plan.
C’est pour conserver ces réglages que SSMS place SET ANSI_NULLS et SET QUOTED_IDENTIFIER avant le CREATE ou l’ALTER PROCEDURE dans le script qu’il génère, par exemple :
SET ANSI_NULLS ON;
GO
SET QUOTED_IDENTIFIER ON;
GO
CREATE PROCEDURE dbo.MaProcedure
AS
    SELECT 1;
GO
SQL Server enregistre ces deux options avec la procédure lors de sa création ou de sa modification, puis utilise ces réglages pour son code statique lors des appels suivants. Les instructions SET en tête du script permettent donc de recréer la procédure avec les mêmes réglages, quelle que soit la configuration initiale de la session qui exécute le script. Ce comportement est décrit dans la documentation de CREATE PROCEDURE, section « Interoperability ».
Ce dédoublement a trois coûts, qu’on mesure sur un même texte exécuté quatre fois dans la même session, sous SET ANSI_DEFAULTS ON, puis OFF, puis ON, puis OFF :
| Entrée | set_options | usecounts | query_hash | query_plan_hash | Exécutions dans sys.dm_exec_query_stats |
|---|---|---|---|---|---|
1 (ON) | 251 | 2 | 0x3765C48B49EA3AD0 | 0x636520DF98647923 | 2 |
2 (OFF) | 266 | 2 | 0x3765C48B49EA3AD0 | 0x636520DF98647923 | 2 |
Le premier coût est une compilation complète de plus : une session d’événements étendus a relevé deux sql_statement_post_compile et deux sp_cache_insert pour ce texte, puis un sp_cache_hit par exécution suivante. Le deuxième est la mémoire d’une deuxième entrée.
Le troisième coût gêne le diagnostic : les quatre exécutions du même texte sont réparties entre deux entrées de sys.dm_exec_query_stats, chacune rattachée à un plan_handle différent. Chaque entrée ne compte que ses deux exécutions et leurs consommations de CPU et de lectures. Un rapport qui regroupe par plan_handle affiche donc deux lignes de deux exécutions ; pour retrouver les quatre exécutions et leur coût total, il faut réunir les statistiques des deux plans. La charge d’une même requête peut ainsi paraître plus faible si l’on examine chaque plan séparément.
Le guide d’architecture du traitement des requêtes, section « Cache multiple plans for the same query » décrit cet exemple autrement. Il dit que la deuxième entrée « ne déclenche pas de recompilation » et que « les deux entrées font référence au même plan », puisqu’elles ont le même query_plan_hash. C’est exact au sens étroit : aucun événement sql_statement_recompile, puisqu’une recompilation, au sens du moteur, remplace le plan d’une entrée existante. Mais le lecteur en conclut que le dédoublement ne coûte rien, alors qu’il coûte une compilation, une entrée et des statistiques séparées. Le même query_plan_hash dit seulement que l’optimiseur est arrivé deux fois à la même forme de plan.
Pour trouver ces doublons dans un cache réel, il faut chercher les sql_handle qui ont plusieurs plan_handle, et afficher les attributs de la clé qui les séparent. Voici le script de mon dépôt tsql-scripts :
-----------------------------------------------------------------
-- Find batch texts with multiple cached plans and compare cache keys
--
-- rudi@babaluga.com, go ahead license
-----------------------------------------------------------------
-- Read-only, instance-wide. Requires VIEW SERVER STATE before SQL Server
-- 2022, or VIEW SERVER PERFORMANCE STATE on SQL Server 2022 and later.
-- Different databases can legitimately have separate plans for the same text.
-- Source: https://www.pachadata.com/docs/articles/sqlserver/internals/cache-de-plans/

SET NOCOUNT ON;
SET TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;

WITH plans AS (
    SELECT DISTINCT qs.sql_handle, qs.plan_handle
    FROM sys.dm_exec_query_stats AS qs
), duplicates AS (
    SELECT sql_handle, COUNT(*) AS plan_count
    FROM plans
    GROUP BY sql_handle
    HAVING COUNT(*) > 1
)
SELECT d.plan_count,
       DB_NAME(CAST(pa.dbid AS int)) AS database_name,
       CAST(pa.set_options AS int) AS set_options,
       CAST(pa.user_id AS int) AS user_id,
       CAST(pa.language_id AS int) AS language_id,
       cp.usecounts,
       LEFT(t.text, 70) AS text_start
FROM duplicates AS d
JOIN plans AS p ON p.sql_handle = d.sql_handle
JOIN sys.dm_exec_cached_plans AS cp ON cp.plan_handle = p.plan_handle
CROSS APPLY sys.dm_exec_sql_text(d.sql_handle) AS t
CROSS APPLY (
    SELECT dbid, set_options, user_id, language_id
    FROM (SELECT attribute, value FROM sys.dm_exec_plan_attributes(cp.plan_handle)) AS s
    PIVOT (MAX(value) FOR attribute IN (dbid, set_options, user_id, language_id)) AS pv
) AS pa
ORDER BY d.plan_count DESC, text_start, set_options
OPTION (RECOMPILE, MAXDOP 1);
Sur mon instance de test, elle a trouvé les trois causes : des set_options différents (l’exemple ci-dessus), des schémas par défaut différents (user_id 1, 5 et 6 pour un même SQL dynamique, voir la section suivante), et des bases différentes.
Ce dernier cas n’est pas un gaspillage : le sql_handle ne contient pas la base, et le même texte exécuté dans deux bases doit avoir deux plans.
Regardez la colonne database_name avant de conclure.
Le schéma par défaut
Quand un batch ad hoc ou préparé nomme un objet sans son schéma, FROM T au lieu de FROM dbo.T, le moteur doit résoudre le nom à partir du schéma par défaut de l’utilisateur, et le plan n’est valable que pour ce schéma. L’attribut user_id contient alors ce schéma. Quand tous les noms sont qualifiés, il vaut -2, et l’entrée se partage entre tous les utilisateurs.
La documentation de sys.dm_exec_plan_attributes dit que toute autre valeur que -2 « représente l’identifiant de l’utilisateur qui soumet la requête ». La mesure dit autre chose. Deux utilisateurs différents (principal_id 7 et 8), de même schéma par défaut (schema_id 6), ont partagé une seule entrée, avec user_id à 6. C’est le schéma par défaut, comme l’avaient écrit Sangeetha Shekar en 2007, Aaron Bertrand en 2014 et Erland Sommarskog. Le nombre d’entrées suit donc le nombre de schémas par défaut distincts parmi les utilisateurs qui exécutent le batch. Dans une base où tout le monde a dbo comme schéma par défaut, un nom non qualifié ne crée pas d’entrée supplémentaire, mais il oblige le moteur à une résolution de plus, et il suffit d’un utilisateur au schéma par défaut différent pour dédoubler les plans.
Les procédures suivent une autre règle. Dans le code statique d’une procédure, une référence de table sans schéma, dans la même base, se résout dans le schéma de la procédure, puis dans dbo. L’équipe SQL Server décrit cette règle dans Name resolution, default schema, implicit schema Part I, publié initialement le 3 avril 2006, au passage « Active Default Schema » ; elle y distingue notamment le SQL dynamique, qui utilise le schéma par défaut de l’utilisateur courant. La documentation Execute a Stored Procedure, section « User-defined stored procedures », précise aussi la recherche dans le schéma de la procédure englobante, puis dans dbo, pour un appel de procédure sans schéma. Pour le vérifier, j’ai créé trois tables T de contenus différents, dbo.T (2 lignes), s1.T (3 lignes) et s2.T (4 lignes), et des procédures qui lisent FROM T sans schéma, appelées par trois utilisateurs de schémas par défaut différents :
CREATE OR ALTER PROCEDURE dbo.P AS SELECT COUNT(*) AS lignes FROM T;
GO
CREATE OR ALTER PROCEDURE s1.P AS SELECT COUNT(*) AS lignes FROM T;
GO
CREATE OR ALTER PROCEDURE dbo.Pdyn AS EXEC (N'SELECT COUNT(*) AS lignes FROM T');
GO
CREATE OR ALTER PROCEDURE dbo.Pspx AS EXEC sp_executesql N'SELECT COUNT(*) AS lignes FROM T';
GO
-- s3.P : même procédure dans un schéma s3 qui n'a pas de table T
EXECUTE AS USER = 'u1'; EXEC dbo.P; EXEC s1.P; EXEC dbo.Pdyn; EXEC dbo.Pspx; REVERT;
| Appelant (schéma par défaut) | dbo.P | s1.P | s3.P | dbo.Pdyn (EXEC) | dbo.Pspx (sp_executesql) |
|---|---|---|---|---|---|
u1 (s1) | dbo.T | s1.T | dbo.T | s1.T | s1.T |
u2 (s2) | dbo.T | s1.T | dbo.T | s2.T | s2.T |
u3 (dbo) | dbo.T | s1.T | dbo.T | dbo.T | dbo.T |
Dans le code statique d’une procédure, FROM T désigne la même table pour tous les appelants. Par exemple, dbo.P lit toujours dbo.T, et s1.P lit toujours s1.T, même lorsque l’appelant a s2 comme schéma par défaut. Pour s3.P, le moteur cherche s3.T puis, comme cette table n’existe pas, utilise dbo.T.
Les trois utilisateurs peuvent donc partager le plan de chaque procédure. Dans cet essai, chaque procédure a une seule entrée de cache, avec usecounts à 3. L’attribut user_id de cette entrée contient l’identifiant du schéma de la procédure : 1 pour dbo, 5 pour s1, 7 pour s3.
Avec le SQL dynamique de dbo.Pdyn et de dbo.Pspx, le choix de la table dépend en revanche de l’appelant : FROM T désigne s1.T pour u1, s2.T pour u2 et dbo.T pour u3. Chaque procédure conserve son propre plan, mais le batch dynamique qu’elle exécute a besoin d’une entrée de cache par schéma par défaut. Pour chacun des deux textes dynamiques, l’essai a donc laissé trois entrées, avec user_id à 5, 6 et 1. Un nom sans schéma dans le SQL dynamique peut ainsi faire lire des tables différentes et multiplier les plans en cache.
Le paramétrage
Un plan n’est réutilisé que si le texte est identique. Une application qui écrit ses valeurs dans le texte de la requête, WHERE InscriptionId = 42 puis WHERE InscriptionId = 43, produirait donc une entrée par valeur. Trois mécanismes permettent de partager un plan entre valeurs : le paramétrage simple, fait par le moteur ; le paramétrage forcé, qu’on active par base ; et les requêtes paramétrées par le client, sp_executesql ou les instructions préparées.
Les plans triviaux
Un plan qui ne laisse aucun choix à l’optimiseur entre dans le cache comme les autres, une entrée par texte. Ce qui change, c’est le prix de sa compilation, et la place qu’il tient dans le paramétrage simple.
Avant de chercher un plan parmi les possibilités, l’optimiseur passe par une étape de plan trivial (trivial plan) : s’il n’existe qu’un plan raisonnable, il le prend sans calculer de coûts.
Une recherche par égalité sur la clé de l’index cluster en est l’exemple type : un seul accès possible, un Clustered Index Seek. Le plan XML l’indique par l’attribut StatementOptmLevel="TRIVIAL" ; sinon, il vaut FULL, et l’optimisation passe par ses phases de recherche (search 0, search 1, search 2), que compte sys.dm_exec_query_optimizer_info. Sur PachaDataFormation, où Inscription.Inscription a son index cluster sur InscriptionId et aucun index sur ContactId :
| Requête | StatementOptmLevel | Phase | Mémoire de compilation | Entrées laissées |
|---|---|---|---|---|
SELECT DateCreation FROM Inscription.Inscription WHERE InscriptionId = 42 | TRIVIAL | aucune | 144 Ko | une shell query de 16 Ko et un plan Prepared de 56 Ko |
la même avec = 43 | aucune optimisation | une shell query de plus | ||
... WHERE ContactId = 42 | FULL | search 1, GoodEnoughPlanFound | 240 Ko | une entrée Adhoc |
la même avec = 43 | FULL | search 1, à nouveau | 240 Ko | une deuxième entrée Adhoc |
| jointure de deux tables sur la clé | FULL | search 1 | 296 Ko | une entrée Adhoc de 88 Ko |
Les deux compilations ont pris 0 à 1 ms ; une jointure avec GROUP BY, 2 ms. Le plan trivial coûte peu à compiler, mais il coûte surtout une seule fois, parce que c’est lui que le paramétrage simple sait partager : la valeur 43 a réutilisé le plan préparé de la valeur 42. La requête sur ContactId, sans index sur cette colonne, n’a pourtant qu’une stratégie raisonnable, le parcours complet. Mais l’index nix_temp_01, qui contient DateCreation, offre une autre façon de lire la colonne demandée, et ce choix fondé sur le coût suffit à faire passer l’optimiseur en FULL. Sur une copie de la table sans cet index, la même requête a un plan TRIVIAL. Ce n’est donc pas la valeur qui compte, mais l’existence d’une alternative : dès que l’optimiseur doit comparer des coûts, le plan n’est plus trivial, le paramétrage simple renonce, et chaque valeur coûte une optimisation et une entrée.
Le paramétrage simple
Le paramétrage simple (simple parameterization), appelé autoparamétrage jusqu’à SQL Server 2000, est actif par défaut. Le moteur remplace les littéraux d’une requête par des paramètres, compile la forme paramétrée et la met en cache comme un plan Prepared. La requête d’origine laisse une deuxième entrée, de type Adhoc, que le livre blanc de Greg Low appelle une shell query, une requête « enveloppe ». Elle ne contient pas l’arbre d’opérateurs du plan partagé : elle conserve des informations sur la requête d’origine et un renvoi vers le plan préparé, visible dans son plan XML par l’attribut ParameterizedPlanHandle, ajouté en 2008. Elle sert à retrouver vite le plan paramétré la prochaine fois que le même texte arrive, sans refaire le paramétrage. Elle a fait 16 Ko dans toutes mes mesures : 8 Ko pour les structures de compilation de l’enveloppe et 8 Ko pour son contexte d’exécution.
Un plan trivial coûte peu à compiler, mais sa préparation demande encore du travail. Pour retrouver un plan préparé à partir d’un texte ad hoc, SQL Server doit analyser ce texte, remplacer les littéraux par des paramètres, normaliser l’instruction et la reconvertir en une représentation SQL utilisable pour la recherche dans le cache. La shell query évite de répéter ces étapes lorsque le même texte, avec les mêmes littéraux, revient.
Dans l’exemple ci-dessous, les textes avec InscriptionId = 42 et InscriptionId = 43 ont chacun leur enveloppe, mais renvoient au même plan Prepared avec InscriptionId = @1. Le plan préparé permet le partage entre plusieurs valeurs ; chaque enveloppe permet de retrouver rapidement ce plan à partir du texte d’origine. Le caractère trivial du plan et l’enveloppe économisent donc du travail à des étapes différentes. Cela ne signifie pas que tout plan trivial nécessite une enveloppe : il s’agit ici du paramétrage effectué par le moteur.
Paul White détaille ce rôle dans Simple Parameterization and Trivial Plans, Part 5, section « Shell Plans Revisited », publié le 8 juin 2022. Il précise que refaire les étapes de paramétrage pour retrouver le plan préparé coûte moins que produire même un plan trivial, mais reste plus coûteux que l’accès par l’enveloppe, un écart qui compte pour des instructions simples exécutées très fréquemment.
Une enveloppe sans arbre d’opérateurs utilise quand même des structures de compilation et d’exécution assez volumineuses. Dans la mesure sur SQL Server 2025 CU10 décrite plus haut, les symboles publics identifient un CCompPlan de 2 448 octets et un CStmtPrepQuery de 2 496 octets dans la partie compilée. Le contexte contient notamment un CXStmtPrepQuery de 2 192 octets et un autre bloc de 2 120 octets dont je n’ai pas déterminé la classe. Les deux pages de 8 Ko ne sont donc bien utilisées : environ 12 Ko sont consommés par l’allocateur, dont les en-têtes et l’alignement, et environ 4 Ko restent disponibles.
Après 100 exécutions supplémentaires de chaque texte, j’ai trouvé deux allocations de plus dans la partie compilée, de 176 et 40 octets. Avec l’alignement, elles consomment 224 octets supplémentaires, toujours dans la même page : l’occupation passe à 75,8 % des 16 Ko. Leur fonction et la cause de leur apparition ne sont pas déterminées. Ces observations ne permettent pas de chiffrer la mémoire qu’une implémentation différente pourrait économiser.
USE PachaDataFormation;
GO
SELECT DateCreation FROM Inscription.Inscription WHERE InscriptionId = 42;
GO
SELECT DateCreation FROM Inscription.Inscription WHERE InscriptionId = 43;
GO
SELECT DateCreation FROM Inscription.Inscription WHERE InscriptionId = 4242;
GO
SELECT p.objtype, p.size_in_bytes, p.usecounts, LEFT(t.text, 90) AS debut_du_texte
FROM sys.dm_exec_cached_plans AS p
CROSS APPLY sys.dm_exec_sql_text(p.plan_handle) AS t
WHERE t.text LIKE N'%Inscription%Inscription%InscriptionId%'
  AND t.text NOT LIKE N'%dm_exec_cached_plans%';
Sur 2025 CU10, ces trois requêtes laissent trois shell queries Adhoc de 16 384 octets et deux plans Prepared de 57 344 octets : (@1 tinyint)SELECT [DateCreation] FROM [Inscription].[Inscription] WHERE [InscriptionId]=@1, utilisé deux fois, et le même texte avec @1 smallint, pour 4242. Le type du paramètre suit la valeur : la plus petite taille d’entier qui la contient. Une application dont les identifiants passent de 255 à 256 puis à 32 768 compile ainsi trois plans préparés. Le texte paramétré est normalisé, crochets autour des noms et espaces retirés, ce qui permet à des textes légèrement différents de retrouver le même plan préparé.
Le moteur ne tente le paramétrage simple que sur une petite classe de requêtes. L’annexe A du livre blanc de Greg Low liste ce qui l’empêche : plusieurs tables dans le FROM, IN, UNION, TOP, DISTINCT, GROUP BY, une sous-requête, une expression de table commune, des prédicats liés par OR, un indicateur de requête, plus de 1 000 paramètres. Une jointure n’est donc jamais paramétrée en mode simple. Et même quand la forme le permet, la tentative n’aboutit que si elle est jugée sûre (safe).
Paul White a montré en 2022, dans sa série Simple Parameterization and Trivial Plans, que le critère est l’étape de plan trivial de l’optimiseur : la tentative est sûre si l’instruction préparée obtient un plan trivial, c’est-à-dire un plan qui ne dépend pas de la valeur.
Sinon, seule la shell query reste en cache, sans plan préparé, et le plan affiché garde pourtant une liste de paramètres, ce qui trompe.
Dans PachaDataFormation, InscriptionId = 42, sur la clé primaire d’Inscription.Inscription, est paramétré ; ContactId = 42 sur la même table, dont le plan n’est pas trivial (voir « Les plans triviaux »), reste Adhoc, comme je l’ai mesuré dans l’article sur les listes IN.
Les compteurs Auto-Param Attempts/sec, Safe Auto-Params/sec, Unsafe Auto-Params/sec et Failed Auto-Params/sec de l’objet SQLServer:SQL Statistics comptent ces tentatives.
Le paramétrage forcé
Le paramétrage forcé (forced parameterization), apparu avec SQL Server 2005, s’active par base :
ALTER DATABASE PachaDataFormation SET PARAMETERIZATION FORCED;
Le moteur paramètre alors presque tous les littéraux, sans tenir compte du plan trivial, sauf exceptions que liste le guide d’architecture : la liste du SELECT, TOP, le motif d’un LIKE, le style de CONVERT, les arguments d’indicateurs, les corps de modules, les instructions déjà paramétrées par le client, les requêtes de plus de 2 097 littéraux, celles qui ont OPTION (RECOMPILE). Les chaînes deviennent des varchar(8000) ou nvarchar(4000), et des varchar(max) ou nvarchar(max) au-delà, les entiers des int, et un entier hors des limites de int, dans un prédicat de comparaison, un numeric(38,0). Changer l’option vide les plans de la base, sauf ceux en cours d’exécution. J’en ai décrit la frontière dans Le Query Store saturé par des identifiants concaténés : un sp_executesql qui a une liste de paramètres, même inutilisée, n’est pas repris par le paramétrage forcé.
Pourquoi le paramétrage déduit-il le type du littéral plutôt que de reprendre celui de la colonne ? Le choix commence dans le parseur, avant que les noms des tables et des colonnes soient résolus dans les métadonnées. À ce stade, le moteur connaît le texte de l’instruction, mais pas encore le type de la colonne comparée. Il reconnaît un littéral entier, puis, dans le contexte d’une comparaison directe, réduit son type au plus petit entier capable de contenir sa valeur. Paul White décrit cet ordre dans Simple Parameterization and Trivial Plans, Part 4, sections « Statement Parsing » et « Initial Data Types », publié le 20 mai 2022.
Même pour une colonne Id de type int, le paramétrage simple peut donc produire :
| Comparaison | Type du paramètre inféré |
|---|---|
Id = 42 | tinyint |
Id = 4242 | smallint |
Id = 424242 | int |
Ces signatures différentes peuvent donner trois plans Prepared distincts, même si leurs opérateurs d’exécution sont identiques. Paul White montre ce dédoublement dans la partie 2, sections « Parameter Data Types » et « Data Type Inference », publiée le 29 mars 2022. La même partie explique qu’un paramétrage explicite, avec un type déclaré correspondant à celui de la colonne, évite cette variation : un paramètre @Id int garde le même type pour les trois valeurs.
Reprendre le type de la colonne pour cette comparaison demanderait donc une autre organisation du processus de compilation. D’après la partie 4 de Paul White, ces règles d’inférence remontent à SQL Server 7.0 et sont conservées pour compatibilité. Il s’agit d’un choix historique d’implémentation. La réduction en tinyint ou smallint décrite ici concerne le paramétrage simple ; le paramétrage forcé applique les règles différentes indiquées dans le paragraphe précédent.
Le paramétrage forcé laisse toujours une shell query Adhoc par texte d’origine. Il réduit le nombre de compilations complètes et la taille des plans, et laisse une entrée par texte.
Les requêtes paramétrées par le client
sp_executesql, les instructions préparées par sp_prepare et les requêtes paramétrées des pilotes donnent un plan Prepared dont le texte commence par la liste des paramètres, (@id int)SELECT .... Cette liste fait partie du texte haché : deux appels qui déclarent le même paramètre avec deux longueurs différentes ont deux plans.
Avec SqlCommand.Parameters.AddWithValue en .NET, le pilote déduit les caractéristiques du paramètre à partir de la valeur fournie. Pour une chaîne courte, il choisit nvarchar et, si la taille n’est pas fixée, reprend la longueur de la chaîne, comme l’indique la documentation de SqlParameter.Size. Il ne consulte pas la définition de la colonne pour choisir cette taille. Ainsi, "Li" donne @nom nvarchar(2) et "Martin" donne @nom nvarchar(6). Le texte du SELECT est identique, mais les déclarations des paramètres diffèrent : ces appels peuvent donc donner deux plans Prepared distincts. Déclarer explicitement le type et la taille correspondant à la colonne stabilise cette signature, conformément aux recommandations de la documentation de configuration des paramètres avec Microsoft.Data.SqlClient.
L’exemple C# suivant suppose une colonne dbo.Client.Nom de type nvarchar(100). Il affiche les caractéristiques des paramètres avant toute exécution : aucune connexion SQL Server n’est nécessaire pour observer l’inférence.
using System;
using System.Data;
using Microsoft.Data.SqlClient;

// Exemple : dbo.Client.Nom est une colonne nvarchar(100).
const string sql = "SELECT COUNT(*) FROM dbo.Client WHERE Nom = @nom;";

// AddWithValue déduit la taille de chaque valeur.
foreach (string nom in new[] { "Li", "Martin" })
{
    using var commande = new SqlCommand(sql);
    SqlParameter parametre = commande.Parameters.AddWithValue("@nom", nom);
    Console.WriteLine($"{nom} : {parametre.SqlDbType}({parametre.Size})");
}

// Le type et la taille correspondent maintenant à la colonne.
foreach (string nom in new[] { "Li", "Martin" })
{
    using var commande = new SqlCommand(sql);
    SqlParameter parametre = commande.Parameters.Add("@nom", SqlDbType.NVarChar, 100);
    parametre.Value = nom;
    Console.WriteLine($"{nom} : {parametre.SqlDbType}({parametre.Size})");
}
Sortie obtenue avec Microsoft.Data.SqlClient 7.1.1 :
Li : NVarChar(2)
Martin : NVarChar(6)
Li : NVarChar(100)
Martin : NVarChar(100)
Dans la première boucle, les deux commandes seraient envoyées avec des tailles de paramètres différentes. Dans la seconde, les valeurs changent mais la déclaration reste @nom nvarchar(100), ce qui permet de réutiliser le plan si les autres conditions de partage du cache sont réunies. Le nombre 100 vient ici de la définition de la colonne ; pour une colonne varchar(100), il faudrait déclarer SqlDbType.VarChar avec la taille 100.
Les procédures stockées et les appels RPC
Le plan d’une procédure stockée est conservé dans Object Plans, et retrouvé par l’identifiant de la procédure. Shekar recommandait en 2007 d’appeler les procédures par un appel RPC du pilote plutôt que par un batch EXEC dbo.Proc 1, 1000 : le batch lui-même est un texte ad hoc, avec ses littéraux.
Dans l’essai sur SQL Server 2025 CU10, le batch composé uniquement de l’appel EXEC dbo.Proc ... n’a pas été conservé en cache, avec la raison ZeroCostPlan ; le plan de la procédure, lui, l’a été. Ce batch d’appel se distingue d’une shell query de paramétrage simple, qui renvoie vers un plan Prepared. Cette mesure ne permet pas de dater un changement de comportement, ni de généraliser à tous les batchs contenant un EXEC.
Un appel RPC (Remote Procedure Call) transmet au serveur le nom de la procédure et ses paramètres typés. Avec un batch texte EXEC dbo.Proc 1, 1000, SQL Server doit d’abord analyser l’instruction, reconnaître l’appel et identifier la procédure avant de rechercher son plan. Le RPC évite ce travail sur le batch d’appel, même lorsque ce batch n’aurait pas été conservé en cache. Le moteur doit toujours retrouver le plan de la procédure et, si nécessaire, le compiler.
La documentation Microsoft sur les verrous de compilation, section « Stored procedure is invoked as a Language event », recommande toujours le RPC pour cette raison. Avec Microsoft.Data.SqlClient, on utilise CommandType.StoredProcedure et le nom de la procédure comme texte de commande. Voici un exemple pour une procédure dbo.Proc qui accepte deux paramètres int, @id et @seuil, avec une connexion connexion déjà ouverte :
using var commande = new SqlCommand("dbo.Proc", connexion);
commande.CommandType = CommandType.StoredProcedure;
commande.Parameters.Add("@id", SqlDbType.Int).Value = 1;
commande.Parameters.Add("@seuil", SqlDbType.Int).Value = 1000;
commande.ExecuteNonQuery();
Le pilote construit l’appel RPC à partir de ces informations. Le bénéfice concerne le traitement de l’appel ; il ne garantit pas un plan unique pour toutes les options de session et ne supprime pas le parameter sniffing.
Le partage d’un plan entre valeurs a un prix : l’optimiseur peut utiliser les valeurs des paramètres connues lors de la compilation, souvent celles de la première exécution. C’est le parameter sniffing. Le plan obtenu peut être excellent pour une valeur rare et mauvais pour une valeur fréquente, ou l’inverse, lorsqu’il est réutilisé.
Cette sensibilité aux valeurs rejoint un problème plus général étudié au moins dès 1992 sous le nom d’optimisation paramétrique (parametric query optimization) : préparer plusieurs plans adaptés à différentes régions de l’espace des paramètres, puis choisir à l’exécution. Les références sont :
- Yannis E. Ioannidis, Raymond T. Ng, Kyuseok Shim et Timos K. Sellis, Parametric Query Optimization, actes de la 18e conférence VLDB, Vancouver, 1992, p. 103-114. Dans le résumé, p. 103, les auteurs recherchent plusieurs plans, « each one of which is optimal for a subset of all possible values of the run-time parameters ». Leur étude porte principalement sur le nombre de pages de buffer disponibles pour une requête, et ne décrit donc pas spécifiquement le parameter sniffing de SQL Server. Les mêmes auteurs en ont publié une version longue, Parametric query optimization, The VLDB Journal, vol. 6, no 2, 1997, p. 132-151, DOI 10.1007/s007780050037.
- Sumit Ganguly, Design and Analysis of Parametric Query Optimization Algorithms, actes de la 24e conférence VLDB, New York, 1998, p. 228-238. Le résumé, p. 228, décrit des plans candidats « each optimal for some region of the parameter space ». La section 1.1 inclut explicitement la sélectivité, la taille des tables et la mémoire disponible parmi les paramètres possibles.
SQL Server 2022 répond en partie à la sensibilité aux valeurs avec Parameter Sensitive Plan optimization, qui permet plusieurs plans à variantes pour une même instruction paramétrée éligible, décrits plus loin.
L’option optimize for ad hoc workloads
Une application qui envoie des milliers de requêtes ad hoc différentes, chacune exécutée une fois, remplit le cache de plans qui ne resserviront jamais. L’option d’instance optimize for ad hoc workloads, apparue avec SQL Server 2008, change ce qui est mis en cache à la première exécution d’un batch : un stub (compiled plan stub) au lieu du plan complet. Le stub contient la clé du cache et un pointeur vers le texte, sans plan. À la deuxième exécution du même texte, le moteur recompile et remplace le stub par le plan complet. Depuis SQL Server 2019, le même réglage existe par base, ALTER DATABASE SCOPED CONFIGURATION SET OPTIMIZE_FOR_AD_HOC_WORKLOADS = ON.
EXEC sp_configure 'show advanced options', 1;
RECONFIGURE;
EXEC sp_configure 'optimize for ad hoc workloads', 1;
RECONFIGURE;
Mesuré sur 2025 CU10, pour une jointure ad hoc non paramétrable :
| Exécution | cacheobjtype | size_in_bytes | usecounts |
|---|---|---|---|
| 1 | Compiled Plan Stub | 456 | 1 |
| 2 | Compiled Plan | 65 536 | 1 |
| 3 | Compiled Plan | 65 536 | 2 |
Le stub est une entrée de cache sans plan d’exécution. Il contient la clé du cache (les mêmes attributs qu’un plan complet : set_options, dbid, user_id, objectid), un renvoi vers le texte et les champs que le store tient pour chaque entrée, dont son coût. sys.dm_exec_query_plan ne rend rien pour lui. Contrairement à un plan, il n’a pas d’objet mémoire à lui : il est alloué dans un objet MEMOBJ_CACHESTORESQLCP de 48 Ko qui appartient au store et que plusieurs stubs partagent, ce qui explique sa taille qui n’est pas un multiple de 8 Ko, et le memory_object_address commun à plusieurs stubs.
À la première exécution, le moteur ne fait pas l’économie de la compilation : il compile le batch entier, l’exécute avec ce plan, puis libère le plan et ne garde que le stub. L’option économise de la mémoire, et coûte du processeur. À la deuxième exécution du même texte sous la même clé, la recherche trouve le stub, et le moteur compile de nouveau, cette fois pour garder le plan. Une requête exécutée deux fois est donc compilée deux fois.
Les compteurs le montrent, relevés autour de trois exécutions de la même jointure :
| Exécution | Entrée | Optimisations | Événements |
|---|---|---|---|
| 1 | Compiled Plan Stub, 456 octets | 1 | plan_not_cached (raison SQLStr), aucun sp_cache_insert |
| 2 | Compiled Plan, 73 728 octets, autre plan_handle | 1 | sp_cache_insert |
| 3 | même plan, usecounts 2 | 0 | sp_cache_hit |
Le compteur SQL Re-Compilations/sec ne bouge pas : remplacer un stub par un plan n’est pas une recompilation. La première exécution laisse une ligne dans sys.dm_exec_query_stats, rattachée au plan_handle du stub. Quand le plan complet arrive, sous un autre plan_handle, sa ligne repart à une exécution : la statistique de la première exécution est perdue avec le stub.
La taille du stub ne dépend pas de la longueur du texte : 456 octets pour un texte de 182 comme de 1 424 octets, parce que le texte est dans le cache SQL Manager. Le stub de la shell query d’une requête paramétrée en mode simple ne fait que 136 octets ; le plan préparé, lui, est complet dès la première exécution, l’option ne le concerne pas. Enfin, usecounts repart à 1 quand le plan remplace le stub : il ne compte pas l’exécution qui avait créé le stub. La taille des stubs a varié selon les versions : environ 300 octets d’après Delaney pour 2012, 424 dans SQL Server Execution Plans (2018), 456 dans SQL Server 2025 Query Performance Tuning de Grant Fritchey et dans mes mesures sur 2019 et 2025, sous Linux et sous Windows.
L’option ne s’applique qu’aux plans compilés après son activation, ne vide pas le cache, et ne concerne pas les plans Prepared de sp_executesql : un identifiant concaténé dans une requête paramétrée par le client donne un plan complet de 48 Ko à chaque valeur, option ou non. La page de l’option dit que les stubs se trouvent en cherchant « Compiled Plan » dans cacheobjtype ; c’est Compiled Plan Stub. Elle propose aussi, pour l’appliquer aux plans déjà en cache, ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE, qui ne vide qu’une base alors que l’option vaut pour l’instance. Ces deux points font l’objet de la PR #10501.
Un stub reste une entrée dans la table de hachage de SQL Plans, avec son propre bucketid. Mes essais sur SQL Server 2019, 2022 et 2025 le confirment : le stub de 456 octets et le plan complet qui le remplace sont dans le même bucket. L’option réduit la mémoire allouée par entrée, mais les stubs comptent toujours dans le nombre d’entrées du store.
Les 40 009 correspondent au nombre de buckets, chacun pouvant contenir plusieurs entrées. Sans l’indicateur de trace 174, le seuil est de 160 036 entrées, soit quatre fois le nombre de buckets, d’après KB3026083. Une charge produisant beaucoup de textes distincts peut donc atteindre ce seuil même avec des stubs : optimize for ad hoc workloads réduit la pression liée à la taille des plans, sans supprimer celle liée au nombre d’entrées.
La documentation Microsoft de l’option, section « Recommendations », précise qu’on ne peut pas consulter le plan d’exécution à partir du cache lorsqu’il ne contient que le stub. Elle recommande l’option pour les serveurs OLTP où les plans ad hoc à usage unique occupent une part importante de la mémoire du moteur.
Erland Sommarskog recommande plus largement la valeur 1 dans Slow in the Application, Fast in SSMS?, section « Auto-parameterisation », pour limiter la mémoire consommée par les applications qui ne paramètrent pas leurs instructions. Il écrit : « There are no known downsides with setting the option to 1. »
Je suis d’accord avec lui, j’ai tendance à mettre cette option à 1 sur tous les serveurs.
Les plans non mis en cache
Certains plans sont compilés sans être mis en cache. L’événement étendu plan_not_cached en donne la raison, parmi 70 valeurs sur 2025 (map plan_not_cached_reason_enum, à lire dans sys.dm_xe_map_values). J’ai suivi sp_cache_insert et plan_not_cached sur une série de batchs :
| batch | Mis en cache | Raison de plan_not_cached |
|---|---|---|
jointure avec OPTION (RECOMPILE) | non | SensInfo, puis WithRecompile |
procédure créée WITH RECOMPILE | non | le batch EXEC : ZeroCostPlan ; la procédure : WithRecompile (état 3) |
EXEC dbo.Proc 7 WITH RECOMPILE | non | le batch : ZeroCostPlan |
SELECT 12 AS x | non | ZeroCostPlan |
SELECT v FROM dbo.T WHERE 1 = 0 | oui, 40 960 octets | aucune |
SELECT TOP (0) v FROM dbo.T | oui, 40 960 octets | aucune |
| littéral de 7 000 caractères | oui, 81 920 octets | aucune |
| littéral de 9 000 caractères | non | ObjWithBlob |
batch avec CREATE TABLE #t, INSERT, SELECT, DROP | oui, 131 072 octets | deux WithRecompile |
SELECT ... INTO dbo.copie | oui, 73 728 octets | aucune |
DROP TABLE dbo.copie | non | ZeroCostPlan |
OPTION (RECOMPILE) sur une requête ad hoc ne laisse aucune entrée. Dans une procédure, c’est différent : le plan de la procédure reste en cache, et l’instruction recompilée reste visible dans sys.dm_exec_query_stats avec sa dernière exécution, ce que j’avais mesuré pour l’article sur la recompilation.
Le « coût nul » des sources a un sens précis. Selon mes observations, il ne s’agit pas d’un plan dont le coût est évalué à zéro. Une requête dont le plan estimé coûte zéro mais qui nomme une table, WHERE 1 = 0 ou TOP (0), est mise en cache.
La raison ZeroCostPlan vise les batchs dont la compilation ne touche aucun objet : SELECT 12, un DROP, le batch EXEC proc. C’est ce que j’ai observé avec les cas ci-dessus.
Selon mes observations, les noms de SensInfo et de SQLStr sont trompeurs. SensInfo évoque une information sensible (sensitive information), mais apparaît pour OPTION (RECOMPILE) sur une requête quelconque : une table utilisateur, une table système, SELECT 1 AS x OPTION (RECOMPILE) sans aucune table.
SensInfo est donnée une fois, au niveau du batch, quand le batch ne contient qu’une instruction et que cette instruction est exclue du cache : une requête OPTION (RECOMPILE) seule, mais aussi un CREATE PROCEDURE, un ALTER TABLE ou un USE seuls dans leur batch. L’instruction reçoit ensuite sa propre raison, WithRecompile. Dès que le batch contient une autre instruction, un DECLARE ou un second SELECT, il reçoit ZeroCostPlan à la place de SensInfo. Aucune source ne décrit cette raison ; la règle vient de ces essais.
SQLStr, de même, ne veut pas dire que le batch n’est pas en cache : elle apparaît pour un batch qui lit une table temporaire créée par un batch précédent, suivie dans la même milliseconde d’un sp_cache_insert du même batch, et pour le stub de optimize for ad hoc workloads.
Les deux situations observées sur SQL Server 2025 CU10 se distinguent ainsi :
| Situation | Événements observés | Résultat dans le cache |
|---|---|---|
| Une requête lit une table temporaire créée par un batch précédent | plan_not_cached avec SQLStr, puis immédiatement sp_cache_insert | Un plan complet est conservé et réutilisé à l’exécution suivante |
Première exécution avec optimize for ad hoc workloads activé | plan_not_cached avec SQLStr, sans insertion du plan complet | Seul le stub est conservé |
La raison SQLStr ne suffit donc pas à déterminer l’état final du cache. Mes essais ne permettent pas d’identifier précisément l’objet ou l’étape interne qu’elle désigne.
La map contient 70 raisons sur 2025 CU10. Plusieurs nomment des produits qui partagent le code du moteur : StretchOverViewOrTVF, DataTierOverViewOrTVF, PolarisSALSp, SynapseBlockingRules, TridentFrontEndInstance (Fabric), CopyInto, Cetas. D’autres désignent des cas internes que leur nom suffit à comprendre : ShowPlanOn, BulkInsert, DropStmt, LargeConst, LargeBatch, FilteredIndex, CEFeedbackHint, CursorIntQuery.
Un littéral de plus de 8 000 octets empêche la mise en cache de tout le batch, d’après les livres blancs de 2005 et 2012, la longueur étant mesurée après le repli des constantes. Le littéral de 9 000 caractères a la raison ObjWithBlob, et non LargeConst, qui existe aussi dans la map. D’après Shekar et Paul White, un batch qui contient une instruction sensible (CREATE LOGIN, une clé, un certificat, ALTER DATABASE) n’est pas mis en cache, même si elle n’est pas exécutée. D’après les livres blancs, ne sont pas mis en cache non plus les plans des requêtes qui créent ou mettent à jour des statistiques, les contextes d’exécution d’un BULK INSERT et, depuis 2012, les plans compilés sous SHOWPLAN_XML, NOEXEC ou PARSEONLY, donc les plans estimés que demande SSMS. Sur 2025 CU10, SHOWPLAN_XML et PARSEONLY ne laissent rien, mais un batch compilé sous NOEXEC laisse une entrée, que l’exécution suivante réutilise.
L’événement uncached_sql_batch_statistics ne dit pas ce que son nom laisse croire. Il s’est déclenché pour des batchs mis en cache comme pour des batchs refusés (RECOMPILE, littéral de 9 000 caractères), mais pas pour les batchs de coût nul : il semble accompagner la première compilation d’un batch qui touche un objet.
Le coût d’une entrée
Chaque entrée d’un store a un coût, que l’éviction utilise pour choisir ce qu’elle retire. Il se lit dans sys.dm_os_memory_cache_entries, colonnes original_cost et current_cost, en joignant sur l’adresse de l’objet mémoire :
SELECT p.objtype, p.usecounts, p.size_in_bytes,
       e.original_cost, e.current_cost
FROM sys.dm_exec_cached_plans AS p
JOIN sys.dm_os_memory_cache_entries AS e
  ON e.memory_object_address = p.memory_object_address
WHERE p.cacheobjtype = N'Compiled Plan';
La jointure ne vaut que pour les plans complets : les stubs partagent leur memory_object_address, et chacun rend plusieurs lignes. La colonne entry_data de sys.dm_os_memory_cache_entries, qui contient un fragment XML pour d’autres caches, est NULL pour SQL Plans et Object Plans.
Voici un exemple autonome avec deux tables temporaires. Le commentaire exemple_cout_entree_cache permet de retrouver uniquement le batch étudié. GO 6, reconnu par SSMS et sqlcmd, exécute six fois le même batch avant de lire son entrée dans le cache. Pour cette mesure, optimize for ad hoc workloads est désactivé et l’instance ne subit pas de pression mémoire.
-- Mesure avec optimize for ad hoc workloads = 0, sans pression mémoire.
USE tempdb;
GO
CREATE TABLE #CoutA (id int NOT NULL PRIMARY KEY, valeur int NOT NULL);
CREATE TABLE #CoutB (id int NOT NULL PRIMARY KEY, valeur int NOT NULL);
INSERT #CoutA VALUES (1, 10), (2, 20);
INSERT #CoutB VALUES (1, 100), (2, 200);
GO
SELECT SUM(a.valeur + b.valeur) AS total
FROM #CoutA AS a
JOIN #CoutB AS b ON b.id = a.id;
-- exemple_cout_entree_cache
GO 6

SELECT p.objtype, p.usecounts, p.size_in_bytes,
       e.original_cost, e.current_cost
FROM sys.dm_exec_cached_plans AS p
JOIN sys.dm_os_memory_cache_entries AS e
  ON e.memory_object_address = p.memory_object_address
CROSS APPLY sys.dm_exec_sql_text(p.plan_handle) AS t
WHERE p.cacheobjtype = N'Compiled Plan'
  AND t.text LIKE N'%-- exemple_cout_entree_cache%'
  AND t.text NOT LIKE N'%sys.dm_exec_cached_plans%';
GO
DROP TABLE #CoutA, #CoutB;
Résultat obtenu sur SQL Server 2025 CU10 (17.0.5035.5, Linux) après les six exécutions, chacune renvoyant total = 330 :
objtype | usecounts | size_in_bytes | original_cost | current_cost |
|---|---|---|---|---|
Adhoc | 6 | 73 728 | 16 | 16 |
Le nombre 16 est ici le coût utilisé pour la conservation de l’entrée dans le cache. Il ne représente ni une durée en millisecondes, ni le coût estimé d’exécution affiché dans le plan. La taille du plan est une autre mesure, size_in_bytes. La section « La montée à chaque réutilisation » montre comment le coût de cache est passé de 0 à 16 au fil des exécutions.
Les sources
Le guide d’architecture du traitement des requêtes décrit le coût ainsi : à l’insertion, le coût courant vaut le coût de compilation, zéro pour un plan ad hoc ; à chaque réutilisation, il est remis au coût de compilation, et celui d’un plan ad hoc augmente, sans dépasser le coût de compilation ; sous pression mémoire, le moteur diminue le coût des plans inutilisés et retire ceux qui atteignent zéro. Les autres sources ne s’accordent ni sur la mesure ni sur la baisse :
| Source | Coût de compilation | Plan ad hoc réutilisé | Baisse sous pression |
|---|---|---|---|
| Arun Marathe (2005), Greg Low (2008, 2012) | somme de ticks, au plus 31 : un pour deux E/S (19 au plus), un pour deux changements de contexte (8 au plus), un pour 16 pages de mémoire (4 au plus) | non précisé | un tick de moins à chaque accès après 50 % du buffer pool |
| Delaney (2012) | mêmes plafonds, un tick par E/S et par changement de contexte | plus 1 à chaque réutilisation | un tick de moins à chaque accès après 50 % du buffer pool ; divisé par deux sous pression mémoire |
| Korotkevitch (2014) | comme Delaney | plus 1 à chaque réutilisation | un de moins à chaque passage du lazy writer |
| Shekar (2007) | deux élevé à la somme des contributions, plafonds 19, 8 et 4 | remis au coût d’origine à la première réutilisation, coût maximal 4 | divisé par deux |
| Slava Oks (2005) | non précisé | non précisé | diminué chaque fois que l’aiguille passe sur une entrée inutilisée, retrait à 0 |
Plusieurs livres, de Professional SQL Server 2005 Performance Tuning (2008) à SQL Server Execution Plans, 3e édition de Grant Fritchey (2018, p. 35, « Plan aging »), décrivent encore un « âge » égal au coût multiplié par le nombre d’utilisations et décrémenté par le lazy writer. C’est le modèle de SQL Server 2000, remplacé en 2005 par l’horloge.
Dans SQL Server 2025 Query Performance Tuning, 7e édition (Apress, 2026), Grant Fritchey décrit toujours un champ d’âge initialisé au coût de génération du plan, rétabli à ce coût lors des réutilisations, et examiné périodiquement par le lazy writer (chapitre 2, « Aging of the Execution Plan », p. 37-38). Il ne reprend pas la multiplication par le nombre d’utilisations. Le coût initial lié à la compilation ne correspond cependant pas aux valeurs de la DMV mesurées ci-dessous sur SQL Server 2025. Ce rapprochement demande de confirmer que le champ décrit par le livre et les colonnes de la DMV représentent bien le même coût interne.
La montée à chaque réutilisation
Sur 2025 CU10, sans aucune pression mémoire, j’ai exécuté douze fois une jointure ad hoc et une procédure, en relevant les deux coûts après chaque exécution :
| Exécution | 1 | 2 | 3 | 4 | 5 | 6 | 7 à 12 |
|---|---|---|---|---|---|---|---|
original_cost et current_cost | 0 | 1 | 2 | 4 | 8 | 16 | 16 |
La suite est la même pour un plan Adhoc, un plan Prepared de sp_executesql et un plan Proc, et la même pour un plan ad hoc de 288 Ko qui joint neuf tables : elle double et plafonne à 16, quelle que soit la taille du plan. original_cost grandit avec current_cost et lui reste égal. Sur PachaDataFormation, une jointure entre Contact.Contact et Contact.Societe exécutée sept fois était aussi à 16.
Dans les essais présentés ici, les colonnes original_cost et current_cost partent de zéro pour les plans Adhoc, Prepared et Proc, puis augmentent avec les réutilisations. La même suite apparaît pour des plans de tailles différentes. Les mêmes valeurs se retrouvent sous Windows, sur 2025 CU9.
Ce résultat diffère de la description du guide Microsoft, section « Remove execution plans from the plan cache », qui réserve le coût initial nul aux plans ad hoc et décrit, pour les autres plans, un coût initial de compilation rétabli à chaque réutilisation. C’est un candidat à une correction de documentation. Avant de proposer une formule de remplacement, il reste à vérifier les versions antérieures et à confirmer la correspondance entre les coûts exposés par la DMV et le coût de compilation décrit dans le guide. Ces essais ne suffisent pas à établir une règle générale d’indépendance entre le coût et la taille d’un plan.
La baisse sous pression
Une « aiguille » (clock hand) est un pointeur qui parcourt les entrées d’un cache store. À chaque passage, le moteur peut diminuer le coût d’une entrée inutilisée ou la retirer si son coût est déjà nul. Nous verrons plus loin comment cela fonctionne.
Pour voir le coût baisser, il faut que l’horloge tourne. J’ai placé dans un cache vide des jointures ad hoc exécutées une à sept fois, donc de coût 0, 1, 2, 4, 8 et 16, un plan préparé et une procédure de coût 16, puis j’ai inséré des milliers de batchs ad hoc distincts en relevant les coûts toutes les vingt insertions. Vers 540 Mo de SQL Plans, avec max server memory à 2 048 Mo, le moniteur de ressources a signalé une mémoire physique basse au niveau du processus (RESOURCE_MEMPHYSICAL_LOW dans sys.dm_os_ring_buffers), et l’aiguille externe a tourné sur tous les stores à la fois :
| Tour de l’aiguille externe | M16 | M8 | M4 | M2 | M1 | M0 | Procédure à 16 |
|---|---|---|---|---|---|---|---|
| avant | 16 | 8 | 4 | 2 | 1 | 0 | 16 |
| 1 | 8 | 4 | 2 | 1 | 0 | retiré | 8 |
| 2 | 4 | 2 | 1 | 0 | retiré | 4 | |
| 3 | 2 | 1 | 0 | retiré | 2 | ||
| 4 | 1 | 0 | retiré | 1 | |||
| 5 | 0 | retiré | 0 | ||||
| 6 | retiré | retiré |
Chaque passage de l’aiguille divise le coût courant par deux, en division entière, et retire l’entrée qu’il trouve à zéro. original_cost ne bouge pas pendant la baisse. Une entrée à 16 survit donc à cinq passages, une entrée à usage unique à aucun. Une procédure, dans Object Plans, suit la même suite. Une entrée en cours d’exécution n’est jamais retirée, même à coût 0 : une requête suivie a traversé soixante-dix tours de l’aiguille sans être retirée. Une réutilisation pendant la pression remet le coût à 16, qu’il soit tombé à 8 ou à 2 : l’entrée retrouve d’un coup toute sa marge. Dans un dernier essai où la pression a tout emporté en moins d’une seconde, l’événement étendu query_cache_removal_statistics a daté le retrait de chaque entrée suivie : M0, puis M1, M2, M4, M8, à deux millisecondes d’intervalle, puis toutes celles à 16 ensemble. Les entrées sortent dans l’ordre de leur coût.
C’est la division par deux de Shekar (2007), déjà décrite pour la pression externe par Delaney dans Inside Microsoft SQL Server 2005, et non le décrément d’un tick que décrivent Low et Korotkevitch.
Le code du moteur
Le moteur a des symboles publics, et on peut voir ses fonctions au débogueur. Sous Linux, j’ai attaché gdb au processus de l’instance de test, lu les adresses des fonctions dans les fichiers de symboles (PDB) que Microsoft publie, et compté les appels pendant une vague de pression. Trois fonctions de sqldk.dll, la bibliothèque de SQLOS, expliquent ce qui précède :
CacheClockAlgorithm::CalculateCostcalcule le coût d’une entrée à partir des ticks de compilation et d’un terme lié au nombre de pages mémoire. Ce terme est calculé en divisant le nombre de pages par 16, avec une division entière, puis en plafonnant le résultat à 4 : 32 pages donnent 2, et 64 pages ou davantage donnent 4. Dans le code machine, la division par 16 est un décalage de quatre bits vers la droite. Ce sont ce que décrivent Marathe et Low ; je n’ai pas établi comment ils se combinent avec la suite 0, 1, 2, 4, 8, 16 mesurée à chaque réutilisation ;TCacheStore::MoveInternal, le pas de l’aiguille, lit pour chaque entrée un mot de 64 bits de sa structure d’horloge (ClockInfo). Elle compare la moitié basse à 1 et divise la moitié haute par deux (instructionshr eax, 1) avant de la réécrire par une écriture atomique (lock cmpxchg). Tout concorde avec une moitié haute qui serait le coût courant et une moitié basse qui marquerait l’entrée en cours d’utilisation, ce qui expliquerait la division par deux mesurée et le fait qu’une entrée en cours d’utilisation n’est jamais retirée ; lu dans le code, pas vérifié dans la mémoire d’une entrée ;- la chaîne d’appel, lue sur les piles, part du moniteur de ressources :
ResourceMonitorTask,CheckIndicators,NotifyMemoryConsumers,TCacheStore::Notify,StartExternalPressure,CacheClockHand::Move, puisMoveInternal. Pendant un passage qui a retiré 2 752 entrées de SQL Plans,MoveInternala été appelée 460 fois : elle traite plusieurs entrées par appel.
Le passage de MoveInternal rapproche plusieurs techniques classiques de programmation système :
- Le vieillissement d’un compteur (aging) réduit progressivement le poids des utilisations anciennes. Décaler un entier non signé d’un bit vers la droite revient à le diviser par deux, en abandonnant le reste :
16,8,4,2,1,0. Dans l’algorithme classique de remplacement de pages, on introduit aussi un bit d’utilisation récente à gauche du compteur. Le cours de Redha Gouicem à RWTH Aachen, section « LRU Approximation With Aging », décrit ce mécanisme. La règle de réutilisation observée dans SQL Server diffère de cette insertion d’un bit. - Le regroupement de plusieurs champs dans un seul entier permet de vérifier et de modifier ensemble un compteur et un état. PostgreSQL emploie cette technique dans son gestionnaire de buffers :
buf_internals.hregroupe un compteur de références, un compteur d’usage et des indicateurs dans un mot de 32 bits. Le commentaire du code explique que ce regroupement permet certaines mises à jour atomiques par une boucle de comparaison et échange. - La comparaison et l’échange atomiques (compare-and-swap, CAS) permettent de remplacer une valeur seulement si elle correspond encore à la valeur attendue. Si un autre thread l’a modifiée entre la lecture et la tentative d’écriture, l’échange échoue ; une boucle peut alors relire la valeur et recommencer le calcul. Cela évite d’écraser une modification concurrente. Mara Bos explique cette technique et l’instruction x86
lock cmpxchgdans Rust Atomics and Locks, chapitre 7, « x86 compare-and-exchange instruction ».
Ces références expliquent les techniques générales. Elles ne documentent pas ClockInfo : l’interprétation de ses deux moitiés comme coût courant et état d’utilisation reste une hypothèse issue de la lecture du code SQL Server.
Le retrait lui-même passe par la destruction du plan (CCacheObject::Destroy, puis le destructeur ~CCompPlan), qui déclenche l’événement query_cache_removal_statistics. Il ne passe pas par la fonction qui déclenche sp_cache_remove : celle-ci n’est appelée que par les retraits explicites, DBCC FREEPROCCACHE, DBCC FREESYSTEMCACHE, les options de base. Une session d’événements sur sp_cache_remove ne voit donc aucune éviction : pendant un essai où query_cache_removal_statistics s’est déclenché 8 241 fois, elle n’a rien reçu. (query_cache_removal_statistics est aussi émis quand un plan non mis en cache est libéré en fin de batch).
SQL Server ne fournit pas de compteur natif documenté équivalent à Page life expectancy (PLE) pour le cache de plans. L’objet de performances SQLServer:Plan Cache expose notamment le nombre d’objets, la taille et le taux de succès des recherches, mais aucune durée de résidence.
Les vues et les événements permettent néanmoins de mesurer plusieurs aspects :
| Information recherchée | Moyen disponible |
|---|---|
| Depuis quand un plan de procédure est en cache | cached_time dans sys.dm_exec_procedure_stats |
| Depuis quand une instruction a été compilée | creation_time dans sys.dm_exec_query_stats ; une recompilation renouvelle cette date, qui ne mesure donc pas nécessairement la durée de résidence de l’entrée |
| Quand un plan disparaît | Capturer les retraits, notamment avec query_cache_removal_statistics, et les rapprocher d’un suivi préalable des plans, en tenant compte des déclenchements pour les plans non mis en cache décrits ci-dessus |
Pour construire un indicateur général, on peut relever périodiquement les plan_handle, avec leur première et leur dernière observation. On estime ainsi la durée de résidence des plans observés, en séparant par exemple les plans à usage unique des plans réutilisés. Les plans déjà présents au début du suivi ont un âge initial inconnu ; ceux encore présents à la fin n’ont pas terminé leur séjour. Les plans créés puis retirés entre deux relevés échappent entièrement à cette mesure.
La moyenne de l’âge des seuls plans actuellement présents serait trompeuse : elle ignore ceux rapidement évincés. Quelques vieux plans peuvent ainsi masquer un renouvellement important du cache. Le coût courant décrit dans cette section n’est pas davantage une durée en secondes : il détermine la résistance d’une entrée aux passages des aiguilles.
Les conséquences
En pratique, un plan devient plus difficile à retirer à chaque réutilisation, jusqu’à la cinquième, et un plan à usage unique est à zéro, donc retiré au premier passage de l’aiguille. Le coût ne dit pas combien le plan a coûté à compiler, mais combien de passages il peut encore traverser, sur une échelle de puissances de deux. Mes essais sur 2019 vont dans ce sens : des plans appelés toutes les 20 secondes ont survécu à près de 78 000 évictions.
Comme nous l’avons vu dans un blog précédent, ce schéma a un nom dans la littérature des systèmes d’exploitation : le vieillissement (aging), décrit par Andrew Tanenbaum pour le remplacement de pages. Chaque page a un compteur ; à chaque tick d’horloge, le compteur est décalé d’un bit vers la droite, ce qui le divise par deux, et le bit d’utilisation de la page est ajouté à gauche. Une page utilisée récemment et souvent a un grand compteur ; une page oubliée voit le sien fondre par moitiés. SQL Server fait la même chose, avec deux différences : le coût double à chaque réutilisation au lieu de recevoir un bit, et la division n’a lieu que quand une aiguille passe, c’est-à-dire sous pression.
L’éviction
Le cadre des caches de SQLOS retire les entrées par un algorithme d’horloge. Chaque store a deux aiguilles (clock hands), visibles dans la vue sys.dm_os_memory_cache_clock_hands :
- l’aiguille interne (
HAND_INTERNAL) tourne quand le store lui-même dépasse une de ses limites, nombre d’entrées ou taille ; elle est déplacée par les threads de travail qui insèrent dans le cache, ce qui allonge leur requête ; - l’aiguille externe (
HAND_EXTERNAL) tourne quand toute l’instance manque de mémoire ; elle est déplacée par le Resource Monitor.
Le guide Microsoft distingue la pression globale, traitée par le Resource Monitor, de la pression propre à un cache, traitée par les threads de travail.
À chaque passage sur une entrée inutilisée, l’aiguille divise son coût courant par deux ; une entrée à zéro est retirée (voir « La baisse sous pression »). Une entrée en cours d’utilisation n’est jamais retirée, sauf à la marquer par DBCC FREESYSTEMCACHE ... WITH MARK_IN_USE_FOR_REMOVAL, qui la retire dès qu’elle se libère. D’après Delaney, un tour met à jour 16 entrées au plus par store ; Shekar ajoute que, sous pression locale, ce nombre double à chaque mouvement de l’aiguille jusqu’à 1 024.
SELECT c.name, h.clock_hand, h.clock_status, h.rounds_count,
       h.removed_all_rounds_count, h.removed_last_round_count
FROM sys.dm_os_memory_cache_clock_hands AS h
JOIN sys.dm_os_memory_cache_counters AS c
  ON c.cache_address = h.cache_address
WHERE c.type IN (N'CACHESTORE_SQLCP', N'CACHESTORE_OBJCP');
Les essais montrent dans quelles situations chaque aiguille intervient :
- Sur SQL Server 2019, SQL Plans a atteint son plafond d’entrées. L’aiguille interne a retiré 39 975 entrées, d’après
removed_all_rounds_count. Le compteur de l’aiguille externe est resté à zéro : seul SQL Plans avait besoin de libérer de la place. - Sur SQL Server 2025 sous Windows, SQL Plans a atteint sa limite de taille (voir « Les limites d’un store »). L’aiguille interne a divisé les coûts par deux, comme l’externe :
16,8,4,2,1en cinq tours. - Les deux aiguilles modifient le même coût pour une entrée donnée. Dans cet essai Windows, un passage de l’aiguille externe a fait baisser le coût de
1à0. L’aiguille interne a ensuite retiré l’entrée. - L’aiguille interne agit uniquement sur son store. Pendant les cinq tours de celle de SQL Plans, une procédure conservée dans Object Plans est restée au coût de
16. - Sur SQL Server 2025 dans un conteneur Linux limité à 3 Go, le résultat était différent. Avec
max server memoryà 2 048, 1 500 ou 800 Mo, la croissance de SQL Plans a déclenché une pression mémoire du processus (RESOURCE_MEMPHYSICAL_LOW) avant que ce store atteigne sa propre limite. L’aiguille externe a alors parcouru tous les stores, tandis que l’interne n’a effectué aucun tour.
Les vagues de pression n’ont pas toutes la même intensité. Dans mes essais, une vague pouvait provoquer un ou deux passages, puis la mémoire se stabilisait. La suivante pouvait en provoquer sept en moins d’une seconde. La mémoire cible est ainsi descendue de 1,7 Go à 500 Mo avant de remonter.
Le mécanisme observé dans SQL Server peut être rapproché de plusieurs algorithmes de remplacement de pages et de gestion de caches.
L’horloge et GCLOCK
L’algorithme d’horloge parcourt les entrées dans un ordre circulaire. Un bit indique si chacune a été utilisée récemment : le parcours donne une seconde chance aux entrées utilisées et peut retirer les autres. Ce mécanisme approche le comportement de LRU (Least Recently Used) sans devoir réordonner une liste à chaque accès. Fernando J. Corbató le décrit pour Multics dans A Paging Experiment with the Multics System, publié en 1969, p. 217-228.
GCLOCK généralise cette idée en remplaçant le bit par un compteur. Dans une forme courante, chaque passage diminue le compteur de un, jusqu’à permettre le retrait de l’entrée. Victor F. Nicola, Asit Dan et Daniel M. Dias analysent cette famille dans Analysis of the Generalized Clock Buffer Replacement Scheme for Database Transaction Processing, SIGMETRICS, 1992.
Le vieillissement
Diviser un compteur par deux fait progressivement perdre du poids aux utilisations anciennes. C’est le principe du vieillissement (aging) décrit par Andrew S. Tanenbaum et Herbert Bos dans Modern Operating Systems, 5e édition, chapitre 3. Le cours de Redha Gouicem à RWTH Aachen explique le décalage du compteur vers la droite et l’ajout d’un bit d’utilisation récente à gauche.
Dans mes essais SQL Server, on retrouve la division par deux au passage d’une aiguille. La mise à jour lors d’une réutilisation suit toutefois une autre règle que l’ajout de ce bit, comme le montre la suite mesurée plus haut.
Le coût de rechargement
Les entrées d’un cache ne coûtent pas toutes aussi cher à recréer. GreedyDual prend en compte le coût des défauts de cache : Neal E. Young le présente dans On-Line Caching as Cache Size Varies, SODA, 1991. Pei Cao et Sandy Irani étendent cette approche aux caches web avec GreedyDual-Size dans Cost-Aware WWW Proxy Caching Algorithms, USITS, 1997, p. 193-206, en tenant aussi compte de la taille des objets.
Cette question se pose également pour les plans : un retrait oblige à compiler à nouveau lors d’un prochain appel, et le coût de compilation varie selon la requête. Cette analogie ne suffit cependant pas à déduire la formule utilisée par SQL Server.
Le rapprochement avec SQL Server
Les observations réunissent plusieurs caractéristiques :
- un parcours circulaire des entrées, comme dans les algorithmes d’horloge ;
- un compteur qui diminue par division entière par deux, comme dans le vieillissement ;
- un coût qui remonte lors des réutilisations, ce qui donne davantage de chances aux entrées réutilisées de rester en cache.
Ces rapprochements sont mon interprétation des mesures et du code observé. Ils ne permettent pas d’affirmer que SQL Server implémente GCLOCK, le vieillissement classique ou GreedyDual à l’identique. De même, le terme « LRU » employé par Slava Oks et Sangeetha Shekar désigne ici une politique approchée : il ne faut pas en déduire que le moteur retire systématiquement le plan dont la dernière utilisation est la plus ancienne.
Les limites d’un store
Un store a deux limites, qui déclenchent toutes deux l’aiguille interne. J’en ai fait le détail dans l’article sur le plafond d’entrées ; en voici l’essentiel.
La première est un nombre d’entrées : quatre fois le nombre de buckets de la table de hachage, soit 160 036 entrées pour SQL Plans et pour Object Plans, chacun séparément. C’est la valeur que donne KB3026083. Lorsque le nombre d’entrées atteint ce seuil, le moteur commence à en retirer pour libérer de la place. De nouvelles entrées peuvent encore arriver pendant ce nettoyage, si bien que le nombre observé peut dépasser légèrement le seuil : sur SQL Server 2019, le store oscillait entre 160 025 et 160 041 entrées. Les stubs de optimize for ad hoc workloads comptent comme des entrées, si bien qu’une charge ad hoc peut atteindre le plafond avec quelques centaines de mégaoctets. L’indicateur de trace 174, au démarrage, fait passer le plafond à 640 004 entrées (160 001 buckets), depuis 2012 SP1 CU14, 2012 SP2 CU5, 2014 RTM CU6 et 2014 SP1 CU1. La KB l’a introduit pour une contention sur le spinlock SOS_CACHESTORE, qui apparaît quand beaucoup de sessions insèrent des plans dans un store plein, ou en même temps dans le même bucket.
Le rapport entre le nombre d’entrées et le nombre de buckets s’appelle le facteur de charge (load factor), noté α. Le NIST le définit ainsi : α = nombre d'entrées / nombre de buckets.
Le seuil de SQL Server correspond à un facteur de charge de 4 : 160 036 entrées pour 40 009 buckets, soit quatre entrées par bucket en moyenne. Ce rapport concerne l’ensemble du store : certains buckets peuvent contenir davantage d’entrées, tandis que d’autres en contiennent moins.
Pour une table avec chaînage et une bonne répartition des clés, le coût moyen d’une recherche est de l’ordre de O(1 + α). Borner le facteur de charge permet de garder des recherches courtes lorsque le nombre total d’entrées augmente. Robert Sedgewick et Kevin Wayne proposent justement comme dimensionnement courant M ≈ N / 4, avec M buckets pour N entrées, dans leurs supports d’Algorithms, section 3.4, diapositive 20. Ce choix correspond lui aussi à quatre entrées par bucket en moyenne.
D’autres implémentations retiennent un seuil différent. Dans le code de Tcl, tclHash.c, REBUILD_MULTIPLIER = 3 déclenche l’agrandissement de la table à environ trois entrées par bucket. La théorie explique l’intérêt de limiter le facteur de charge ; le seuil précis relève d’un compromis entre :
- le temps nécessaire pour parcourir les entrées d’un bucket ;
- la mémoire des structures d’une table comportant davantage de buckets ;
- les coûts de synchronisation entre threads lors des accès concurrents.
Dans SQL Server, KB3026083 documente la contention sur SOS_CACHESTORE et l’augmentation du nombre de buckets avec l’indicateur 174. Le rapport de quatre entrées par bucket est conservé.
Je n’ai trouvé aucune source Microsoft expliquant le choix précis de 4. Un compromis ajusté par des mesures paraît plausible, mais son origine empirique reste une hypothèse. La recommandation de Sedgewick et Wayne montre que cette valeur apparaît ailleurs ; elle n’établit pas l’origine du choix de Microsoft.
La seconde limite est une taille. La limite de pression du cache de plans dépend de la mémoire cible visible :
| Version | Limite de pression |
|---|---|
| SQL Server 2000 | 4 Go |
| 2005 RTM et SP1 | 75 % de 0 à 8 Go, plus 50 % de 8 à 64 Go, plus 25 % au-delà |
| 2005 SP2 et suivantes | 75 % de 0 à 4 Go, plus 10 % de 4 à 64 Go, plus 5 % au-delà |
| avec l’indicateur de trace 8032 | retour à la formule de 2005 RTM |
Un store entre en pression locale à 62,5 % de cette limite, d’après Delaney et Korotkevitch, la seule source de ce chiffre. Pour une mémoire cible de 5 185 Mo, la limite d’un store vaut ainsi (3 072 + 109) × 62,5 % = 1 988 Mo, et j’ai mesuré un palier à 1 972 Mo sur 2019. Pour une mémoire cible de 128 Go, la limite d’un store est d’environ 7,6 Go : au-delà de 4 Go, chaque Go de mémoire cible ajouté n’agrandit la limite d’un store que de 64 Mo, et de 32 Mo au-delà de 64 Go.
La formule n’a pas été republiée par Microsoft depuis le livre blanc de 2012, et je ne l’ai vérifiée qu’une fois, à 5 Go, sur 2019. Sur 2025, le conteneur Linux ne permet pas de la voir : la pression externe arrive toujours avant (voir « L’éviction »), et la mémoire cible y est plafonnée par la couche d’abstraction de SQL Server sous Linux (SQLPAL), à 1 735 Mo pour un max server memory de 2 048 Mo.
Sous Windows, la limite se voit. Sur une instance 2025 CU9 dans une machine virtuelle de 4 Go, où la mémoire cible est égale à max server memory, j’ai rempli SQL Plans de batchs ad hoc distincts jusqu’à ce qu’une aiguille tourne. À 1 280 et à 1 536 Mo, c’est l’aiguille interne qui a tourné, sans aucune notification du moniteur de ressources, et SQL Plans a plafonné ainsi :
| Mémoire cible | Formule : 75 % × 62,5 % | Palier mesuré de SQL Plans | Palier / formule |
|---|---|---|---|
| 1 280 Mo | 614 400 Ko | 583 648 Ko | 95,0 % |
| 1 536 Mo | 737 280 Ko | 700 300 à 700 500 Ko (trois passes) | 95,0 % |
La forme de la formule tient, proportionnelle à la mémoire cible au millième près, mais le palier se trouve à 95 % de la valeur qu’elle annonce, soit 44,5 % de la mémoire cible.
Deux lectures sont possibles : une marque basse, où l’aiguille commence à retirer un peu avant la limite pour ne pas l’atteindre, ou un seuil de 19/32 au lieu de 20/32 (62,5 %). Au palier, l’aiguille retire un plan par plan inséré, et un tour complet retire environ 10 400 entrées, tout le store. À 1 024 Mo, en revanche, la pression externe est arrivée la première, vers 430 Mo de SQL Plans, comme sous Linux. L’indicateur de trace 8032 ne se met qu’au démarrage (DBCC TRACEON (8032, -1) est refusé à chaud), et sous 4 Go de mémoire cible les deux formules donnent toutes deux 75 % : avec -T8032, le palier n’a pas bougé, ce qui ne dit rien de son effet au-delà de 4 Go.
Le changement de 2005 SP2 a une histoire : en 64 bits, sous 2005 RTM ou SP1, les plans à usage unique pouvaient occuper la moitié de la mémoire du serveur, d’après Jonathan Kehayias et Ted Krueger (Troubleshooting SQL Server: A Guide for the Accidental DBA, Redgate, 2011, chapitre 4, section « Significantly larger procedure cache », p. 142). La documentation de l’indicateur 8032 avertit que son retour à l’ancienne formule peut nuire aux autres consommateurs de mémoire.
La mémoire du cache
Les vues et le compteur de performances ne mesurent pas la même chose. Après 2 000 batchs ad hoc distincts et trois procédures, sur 2025 CU10 :
| Source | SQL Plans | Object Plans | Bound Trees |
|---|---|---|---|
sys.dm_exec_cached_plans, somme de size_in_bytes | 121 240 Ko | 376 Ko | 4 928 Ko |
sys.dm_os_memory_clerks, pages_kb | 128 712 Ko | 384 Ko | 5 104 Ko |
sys.dm_os_memory_cache_counters, pages_kb | 128 784 Ko | 384 Ko | 5 104 Ko |
sys.dm_os_memory_cache_entries, somme de pages_kb | 48 536 Ko | 200 Ko | 4 928 Ko |
compteur Cache Pages, en pages de 8 Ko | 82 776 Ko | 8 Ko | 360 Ko |
Le clerk de mémoire et sys.dm_os_memory_cache_counters concordent, et dépassent d’environ 6 % la somme des size_in_bytes. L’écart se retrouve exactement. Dans une seconde mesure, après 2 000 batchs ad hoc, le clerk de SQL Plans valait 137 696 Ko, et la somme de trois termes donnait 137 672 Ko : 130 192 Ko de size_in_bytes, 4 976 Ko d’objets MEMOBJ_CACHESTORESQLCP (la mémoire propre du store, où vivent les stubs et les structures des entrées) et 2 504 Ko d’objets MEMOBJ_SQLMGR, le cache SQL Manager qui garde les textes.
Dans ces mesures, la somme des pages_kb de sys.dm_os_memory_cache_entries représentait seulement 36 à 40 % de la mémoire comptabilisée par le clerk. Ce champ décrit la taille de l’entrée lors de son insertion dans le cache. Dans mes essais, il conservait cette valeur même lorsque la mémoire utilisée augmentait ensuite.
Une requête préparée avec sp_prepare permet de voir la différence :
| Moment du relevé | pages_kb (Ko) | size_in_bytes (octets) |
|---|---|---|
| Après la préparation, avant toute exécution | 48 | 57 344 |
| Après la première exécution | 48 | 139 264 |
La première exécution a construit le contexte d’exécution : la mémoire supplémentaire apparaît dans size_in_bytes, tandis que pages_kb reste à 48. Dans la mesure du store, les contextes d’exécution représentaient environ la moitié de la mémoire totale. Cela explique une grande partie de l’écart.
Pour choisir la mesure adaptée :
sys.dm_os_memory_cache_entries.pages_kbdonne la taille enregistrée à l’insertion, utilisée par SQLOS pour gérer l’entrée ;sys.dm_exec_cached_plans.size_in_bytesdonne la mémoire du plan et des contextes d’exécution conservés avec lui, y compris leur croissance après l’insertion ;- le clerk ou
sys.dm_os_memory_cache_countersdonne la mémoire de l’ensemble du store, avec ses structures de gestion.
Les compteurs de performances peuvent aussi être décalés dans le temps. Dans ces essais, Cache Pages et Cache Object Counts avaient quelques secondes de retard sur les vues. Pour suivre la taille et le nombre d’entrées d’un store, j’utilise donc sys.dm_os_memory_cache_counters :
SELECT name, type, entries_count, entries_in_use_count, pages_kb / 1024 AS mo
FROM sys.dm_os_memory_cache_counters
WHERE type IN (N'CACHESTORE_SQLCP', N'CACHESTORE_OBJCP',
               N'CACHESTORE_PHDR', N'CACHESTORE_XPROC');
Le cache de plans est hors du buffer pool, mais dans la mémoire que limite max server memory, comme le dit le guide d’architecture de la mémoire, tandis que la page de cette option parle du seul buffer pool : à 1 024 Mo, 60 000 requêtes ad hoc font monter le cache de plans à environ 400 Mo et descendre le buffer pool d’autant. Le cache peut aussi peser plus lourd que les données : sur une instance de 4 Go, j’ai vu SQL Plans à 150 Mo et Bound Trees à 153 Mo, à eux deux près de deux fois le cache de données (158 Mo). J’ai proposé de corriger la portée de max server memory dans la PR #10471. Bound Trees est souvent oublié dans ces comptes ; il contient les arbres des vues et des contraintes, et occupe de la mémoire comme les plans.
L’invalidation et la recompilation
Un plan en cache peut devenir faux quand un objet dont il dépend change, ou moins bon quand les données ont changé. Avant de s’en servir, le moteur vérifie s’il reste valable. S’il le juge invalide, il recompile l’instruction concernée, et seulement elle, depuis SQL Server 2005 : le nouveau plan remplace l’ancien dans la même entrée. Le plan_handle ne change pas, plan_generation_num augmente de 1, usecounts continue, execution_count repart à 1 dans sys.dm_exec_query_stats, et creation_time dans sys.dm_exec_query_stats prend l’heure de la recompilation. Une recompilation ne retire donc rien du cache.
SELECT qs.plan_handle, qs.plan_generation_num, qs.creation_time,
       qs.execution_count, LEFT(t.text, 80) AS debut_du_texte
FROM sys.dm_exec_query_stats AS qs
CROSS APPLY sys.dm_exec_sql_text(qs.sql_handle) AS t
ORDER BY qs.plan_generation_num DESC;
Un plan_handle qui change d’un relevé à l’autre veut dire que le plan est sorti du cache ; un plan_generation_num qui augmente sur le même plan_handle, qu’il a été recompilé sur place. creation_time ne départage pas les deux, puisqu’elle donne l’heure de compilation, pas celle de l’entrée dans le cache.
L’événement étendu sql_statement_recompile donne la cause, dans le champ recompile_cause. La map statement_recompile_cause compte 34 valeurs sur 2025 CU10, contre 23 sur 2022 CU26 et 14 dans le livre blanc de 2012 ; la page de l’ancienne classe d’événements SQL:StmtRecompile n’en connaît que 11. J’ai provoqué les plus courantes :
| Action | Cause relevée |
|---|---|
SET CONCAT_NULL_YIELDS_NULL OFF dans le corps d’une procédure | Set option change, à la première exécution seulement |
CREATE TABLE #t puis INSERT et SELECT dans une procédure | Deferred compile, pour l’INSERT et le SELECT, à la première exécution |
ALTER TABLE ... ADD sur une table utilisée | Schema changed |
6 000 lignes modifiées sur 10 000, puis une jointure avec GROUP BY | Statistics changed |
les mêmes modifications, puis un COUNT(*) au plan trivial | aucune recompilation |
UPDATE STATISTICS ... WITH FULLSCAN sans modification préalable | aucune recompilation |
| table temporaire qui passe de 10 à 10 000 lignes entre deux exécutions | Statistics changed |
Ces essais donnent plusieurs résultats :
- Le plan trivial ne s’est pas recompilé après un changement massif des statistiques.
- Le recalcul d’une statistique sans modification préalable des données n’a pas déclenché de recompilation.
- L’instruction
SETdans la procédure a déclenché une seule recompilation, lors de la première exécution. - L’augmentation du nombre de lignes de la table temporaire a déclenché une recompilation avec la cause
Statistics changed.
La cause Temp table changed apparaît dans un autre cas : une procédure lit une table temporaire créée en dehors d’elle, puis la définition de cette table change entre deux exécutions de la procédure. L’exemple suivant montre ce comportement :
CREATE OR ALTER PROCEDURE dbo.q_ext AS SELECT COUNT(*) AS n FROM #t WHERE a > 0;
GO
CREATE TABLE #t (a int);
EXEC dbo.q_ext;                       -- compilation, mise en cache
EXEC dbo.q_ext;                       -- réutilisation
GO
ALTER TABLE #t ADD b int NULL;
GO
EXEC dbo.q_ext;                       -- Temp table changed
GO
DROP TABLE #t;
GO
CREATE TABLE #t (a bigint);
EXEC dbo.q_ext;                       -- Temp table changed
GO
CREATE INDEX ix ON #t (a);
GO
EXEC dbo.q_ext;                       -- Schema changed
La table peut avoir été créée par le batch appelant, par une procédure appelante, ou par un batch précédent de la session ; un batch ad hoc qui relit #u après un ALTER TABLE #u ADD donne la même cause. Un index ajouté donne Schema changed. Dans la procédure qui crée elle-même #t, un ALTER TABLE donne Schema changed à la première exécution, puis plus rien. Le détail des seuils et des cas est dans La recompilation des plans et Les statistiques et les plans en cache.
sp_recompile sur une table ne retire rien du cache : les plans qui la lisent restent, et chacun se recompile à sa prochaine exécution. Sur une procédure, il retire son plan (sp_cache_remove donne la raison Sp module recompile).
Le vidage du cache
Vider le cache, c’est en retirer des entrées sans qu’aucune limite ne l’exige. Les commandes :
| Commande | Effet | Depuis |
|---|---|---|
DBCC FREEPROCCACHE | tout le cache de plans de l’instance | 2000 au moins |
DBCC FREEPROCCACHE (plan_handle) | un plan ; avec un sql_handle, les plans d’un batch ; avec un nom de pool, les plans d’un pool du Resource Governor | 2008 |
DBCC FREESYSTEMCACHE ('SQL Plans') | les entrées inutilisées d’un store ; 'ALL' pour tous les caches | 2005 |
ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE | les plans de la base courante | 2016 |
ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE plan_handle | un plan de la base courante | 2019 |
Pour retirer le plan d’une seule requête, la forme la plus sûre est la première avec un plan_handle, retrouvé par son texte :
SELECT p.plan_handle, p.usecounts, LEFT(t.text, 80) AS debut_du_texte
FROM sys.dm_exec_cached_plans AS p
CROSS APPLY sys.dm_exec_sql_text(p.plan_handle) AS t
WHERE t.text LIKE N'%DateCreation%FROM%Inscription%'
  AND t.text NOT LIKE N'%dm_exec_cached_plans%';

-- remplacez la valeur par un plan_handle rendu par la requête précédente
DBCC FREEPROCCACHE (0x060005006583130FA0E2279A0D00000001000000000000000000000000000000000000000000000000000000);
Pour une requête paramétrée par le moteur, c’est l’entrée Prepared qu’il faut retirer : retirer la shell query Adhoc laisse le plan en cache.
DBCC FREESYSTEMCACHE ('SQL Plans') laisse les procédures, ('Object Plans') laisse l’ad hoc. Les deux ne retirent que les entrées inutilisées au moment de la commande. Delaney et Low citent aussi DBCC FLUSHPROCINDB, non documentée, que CLEAR PROCEDURE_CACHE remplace.
Les reconfigurations et les options de base
Certaines opérations vident le cache sans qu’on le demande. J’ai placé une entrée ad hoc et une procédure dans trois bases, la base de test, une seconde base et master, puis exécuté chaque action en suivant sp_cache_remove :
| Action | Base de test | Autre base | master | Méthode et raison de sp_cache_remove |
|---|---|---|---|---|
max degree of parallelism de 0 à 2, ou de 2 à 0 | vidé | vidé | vidé | Proc Cache Flush, Server reconfiguration |
cost threshold for parallelism de 5 à 10 | vidé | vidé | vidé | idem |
max server memory de 2 048 à 2 000 Mo | vidé | vidé | vidé | idem |
max server memory de 2 000 à 2 048 Mo | gardé | gardé | gardé | aucun |
RECONFIGURE sans changement de valeur | gardé | gardé | gardé | aucun |
optimize for ad hoc workloads de 0 à 1 | gardé | gardé | gardé | aucun |
CLEAR PROCEDURE_CACHE dans la base de test | vidé | gardé | gardé | Compplan Remove, Database settings update |
DBCC FREEPROCCACHE (plan_handle) | l’entrée seule | gardé | gardé | Compplan Remove, Dbcc command flush |
ALTER DATABASE ... SET AUTO_UPDATE_STATISTICS_ASYNC ON | vidé | gardé | gardé | Compplan Remove, Database state update |
ALTER DATABASE ... SET COMPATIBILITY_LEVEL = 160 | vidé | gardé | gardé | Compplan Remove, Database compatibility update |
DBCC CHECKDB | gardé | gardé | gardé | aucun |
sp_recompile sur une table | gardé | gardé | gardé | aucun |
La page de DBCC FREEPROCCACHE liste seize options de configuration qui vident le cache, dont max degree of parallelism, cost threshold for parallelism, max server memory, min server memory, max worker threads, user options et query governor cost limit. Pour max server memory, la mesure nuance : le cache n’est vidé qu’à la baisse. Sous Windows, une baisse de 48 Mo a vidé les trois stores, alors qu’une hausse de 48 Mo puis une hausse de 576 Mo (de 1 024 à 1 600 Mo) n’ont rien retiré, et le retour de 1 600 à 1 024 Mo a de nouveau tout vidé. La mesure a été faite deux fois. Sous Linux, j’avais obtenu le même résultat avec 48 Mo dans chaque sens. Changer MAXDOP en production vide donc les plans de toutes les bases, et l’instance recompile ensuite toute sa charge ; le réglage par base, ALTER DATABASE SCOPED CONFIGURATION SET MAXDOP, ne vide que la base.
Vider une base retire aussi les variantes de ses procédures à paramètres sensibles, rangées dans SQL Plans (voir plus loin). DBCC CHECKDB ne vide plus le cache depuis 2005 SP2.
La documentation se contredit sur la portée des options de base. La page ALTER DATABASE dit que COLLATE, MODIFY_NAME, OFFLINE, ONLINE, PAGE_VERIFY, READ_ONLY, READ_WRITE et quelques options de groupes de fichiers vident le cache de l’instance, et ajoute AUTO_CLOSE, la suppression d’un instantané et la reconstruction du journal ; la page des options SET ajoute la restauration et le détachement ; la page DROP DATABASE limite la suppression d’un instantané à ses propres plans, la page RESTORE limite la restauration à la base restaurée, et le livre blanc de Greg Low sur SQL Server 2012 range SET ONLINE, SET OFFLINE et MODIFY NAME parmi les vidages limités à la base. Je les ai mesurés un par un, de la même façon que le tableau précédent :
| Action | Base touchée | Autre base | master | Raison de sp_cache_remove |
|---|---|---|---|---|
SET OFFLINE WITH ROLLBACK IMMEDIATE | vidé | gardé | gardé | Database shutdown |
SET ONLINE | rien à vider | gardé | gardé | aucune |
MODIFY NAME | vidé | gardé | gardé | Database name change |
SET READ_ONLY, puis SET READ_WRITE | vidé chaque fois | gardé | gardé | Database shutdown |
SET PAGE_VERIFY TORN_PAGE_DETECTION | vidé | gardé | gardé | Database state update |
COLLATE French_CI_AS d’une base vide | vidé | gardé | gardé | Database collation update |
RESTORE DATABASE ... WITH REPLACE | vidé | gardé | gardé | Database shutdown |
DROP DATABASE d’un instantané | vidé (l’instantané) | gardé, base source comprise | gardé | Drop database |
DROP DATABASE d’une base utilisée | vidé | gardé | gardé | Drop database |
MODIFY FILEGROUP DEFAULT, READ_ONLY, READ_WRITE | vidé chaque fois | gardé | gardé | non relevée dans cette passe |
| détachement puis rattachement | vidé | gardé | gardé | non relevée dans cette passe |
DBCC FREESYSTEMCACHE ('ALL') | vidé | vidé | vidé | System Flush, un événement par store |
Le contrôle des plan_handle confirme cette portée sur SQL Server 2019 CU32-GDR (15.0.4500.2), 2022 CU27-GDR (16.0.4305.5) et 2025 CU10 (17.0.5035.5), dans des conteneurs Linux neufs. Les trois types de plans, Adhoc, Prepared et Proc, ont été suivis dans la base modifiée, une autre base et master. Les essais couvrent aussi les options de groupes de fichiers et le détachement. La suppression d’un instantané conserve les plans de sa base source.
La passe initiale sur 2025 CU10 avait également suivi les événements, ce qui précise le mécanisme de retrait :
- Les plans de la base concernée sont retirés un par un, avec la méthode
Compplan Removeet un événement par entrée. SET ONLINEne retire rien dans cet essai : le passage précédent àOFFLINEavait déjà retiré les plans.READ_ONLYetREAD_WRITEferment la base. Ils donnent donc la même raison de retrait,Database shutdown, qu’OFFLINEetRESTORE.
Ces résultats diffèrent de la portée à toute l’instance annoncée par la page ALTER DATABASE. Ils concordent avec les pages RESTORE et DROP DATABASE, ainsi qu’avec le livre blanc de Greg Low cité plus haut.
J’avais déjà mesuré dans La fermeture automatique d’une base que AUTO_CLOSE ne retire que les plans de la base fermée, sur 2019, 2022 et 2025.
La reconstruction du journal reste à mesurer.
Le message du journal
Un vidage de store écrit dans le journal d’erreurs un message de ce genre :
SQL Server has encountered 5 occurrence(s) of cachestore flush for the 'Object Plans' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
Le journal cumule les vidages avant d’en publier le nombre. Dans mes essais, l’écriture attendait un nouveau vidage après un intervalle d’au moins cinq minutes :
- à
13:20:43, un premier bloc de messages a compté les vidages depuis13:15; - à
13:27:03, unDBCC FREEPROCCACHEa déclenché l’écriture du bloc suivant.
La fin du message indique l’origine des vidages :
due to 'DBCC FREEPROCCACHE' or 'DBCC FREESYSTEMCACHE' operationspour ces commandes ;due to some database maintenance or reconfigure operationspour les opérations de maintenance ou de reconfiguration.
Dans ces essais, CLEAR PROCEDURE_CACHE, les options de base et DBCC FREEPROCCACHE (plan_handle) ont retiré des entrées sans vider un store. Ces opérations n’ont produit aucun message de ce type.
Le message constitue donc un bilan des vidages depuis l’écriture précédente. Il ne donne ni l’heure de chaque action ni la base concernée. Pour suivre les retraits individuellement, j’utilise les événements étendus :
sp_cache_removepermet de suivre les vidages et les retraits explicites ;query_cache_removal_statisticspermet d’observer les retraits lors des évictions par l’horloge, avec la réserve sur les plans non mis en cache expliquée plus haut.
Les plans à variantes
SQL Server 2022 a ajouté l’optimisation des plans sensibles aux paramètres (Parameter Sensitive Plan optimization, PSP), au niveau de compatibilité 160. À la compilation, le moteur repère dans l’histogramme d’une statistique jusqu’à trois prédicats d’égalité paramétrés dont la cardinalité varie beaucoup selon la valeur. Au lieu d’un plan, il compile un plan répartiteur (dispatcher plan), qui contient pour chaque prédicat une borne basse et une borne haute découpant les cardinalités en trois plages. À l’exécution, le répartiteur calcule la plage de la valeur et appelle une variante de requête (query variant), compilée à sa première utilisation et mise en cache comme une instruction préparée.
PSP est disponible dans les éditions Enterprise, Standard et Express de SQL Server 2022 et de SQL Server 2025, ainsi que dans l’édition Web de 2022, d’après les tableaux des fonctionnalités par édition. La base doit être au niveau de compatibilité 160 ou supérieur.
J’ai mesuré la répartition dans le cache sur 2025, au niveau 170, avec une procédure dont le paramètre désigne un client de 100 000 lignes ou un client d’une ligne :
| Entrée | Type | store | Contenu |
|---|---|---|---|
| répartiteur de la procédure | Proc | Object Plans | élément <Dispatcher> avec ParameterSensitivePredicate LowBoundary="100" HighBoundary="100000" et la statistique utilisée |
| variante 1 | Prepared | SQL Plans | texte terminé par option (PLAN PER VALUE(ObjectID = 1669580986, QueryVariantID = 1, predicate_range(... = @c, 100.0, 100000.0))) |
| variante 3 | Prepared | SQL Plans | même texte, QueryVariantID = 3 |
Pour identifier une variante et retrouver sa procédure d’origine :
- L’attribut
objectidde la variante, danssys.dm_exec_plan_attributes, est un hachage.sys.dm_exec_sql_textrenvoie unobjectidàNULL. Pour retrouver la procédure, il faut lire l’ObjectIDdans le textePLAN PER VALUE. - Le numéro de variante apparaît dans ce même texte. On le retrouve aussi dans l’attribut
QueryVariantIDde l’élémentQueryPlandu plan XML. - Les commentaires du corps de la procédure ne sont pas recopiés dans le texte des variantes. Pour chercher celles-ci dans le cache, utiliser un filtre sur
PLAN PER VALUE, comme dans la requête ci-dessous.
SELECT p.objtype, p.usecounts, p.size_in_bytes, t.text
FROM sys.dm_exec_cached_plans AS p
CROSS APPLY sys.dm_exec_sql_text(p.plan_handle) AS t
WHERE t.text LIKE N'%PLAN PER VALUE%'
  AND t.text NOT LIKE N'%dm_exec_cached_plans%';
Les statistiques d’exécution sont dans les variantes : sys.dm_exec_query_stats n’avait aucune ligne pour le plan de la procédure, deux lignes pour les variantes, de même query_hash et de query_plan_hash différents, tandis que sys.dm_exec_procedure_stats comptait les trois exécutions. Le même mécanisme vaut pour sp_executesql, dont le répartiteur est alors un plan Prepared de SQL Plans. Une page de la documentation avait inversé les stores du répartiteur et des variantes ; Microsoft l’a corrigée en 2026.
Le niveau 160 suffit pour PSP. Sur 2025, la même procédure a donné au niveau 160 exactement les mêmes entrées qu’au niveau 170 : un répartiteur, les variantes 1 (valeur rare, une ligne estimée) et 3 (valeur fréquente, 100 000 lignes), les mêmes bornes 100 et 100 000.
SQL Server 2025 étend PSP à plusieurs prédicats d’une même table et ajoute, au niveau 170, l’optimisation des paramètres facultatifs (optional parameter plan optimization, OPPO), qui utilise les mêmes répartiteurs et variantes pour les prédicats col = @p OR @p IS NULL. Les conditions d’activation d’OPPO sont le niveau de compatibilité 170 et OPTIONAL_PARAMETER_OPTIMIZATION = ON, activé par défaut.
La différence se voit sur une procédure de ce type :
CREATE OR ALTER PROCEDURE dbo.p_oppo @c int = NULL
AS SELECT SUM(montant) AS s FROM dbo.Commande WHERE client_id = @c OR @c IS NULL;
GO
EXEC dbo.p_oppo 2; EXEC dbo.p_oppo NULL; EXEC dbo.p_oppo 3; EXEC dbo.p_oppo NULL;
Au niveau 160, la procédure n’a reçu qu’une variante PSP, prévue pour une ligne, qui a servi aux quatre appels, y compris aux deux appels avec NULL qui lisent les 200 000 lignes de la table avec un plan prévu pour une. Au niveau 170, elle a reçu deux variantes, dont le texte combine les deux mécanismes :
option (PLAN PER VALUE(ObjectID = 178099675, QueryVariantID = 1, optional_predicate(@c IS NULL),
        predicate_range([cachelab].[dbo].[Commande].[client_id] = @c, 100.0, 100000.0)))
option (PLAN PER VALUE(ObjectID = 178099675, QueryVariantID = 4, optional_predicate(@c IS NULL),
        predicate_range([cachelab].[dbo].[Commande].[client_id] = @c, 100.0, 100000.0)))
La variante 4 estime 200 000 lignes, pour @c IS NULL, la variante 1 en estime une, pour une valeur rare. Les numéros 1, 3 et 4 ne sont pas un compteur : ils désignent la case choisie par le répartiteur (valeur rare, valeur fréquente, paramètre absent). Les variantes comptent dans le plafond d’entrées de SQL Plans, ce que la page de PSP signale.
Dans les publications consultées, je n’ai pas trouvé de description scientifique de la conception de PSP telle qu’elle est livrée dans SQL Server.
Son principe se rapproche de l’optimisation paramétrique décrite en 1992 par Yannis E. Ioannidis, Raymond T. Ng, Kyuseok Shim et Timos K. Sellis dans Parametric Query Optimization, VLDB, p. 103-114 : préparer plusieurs plans adaptés à différentes régions de l’espace des paramètres, puis sélectionner à l’exécution celui qui convient aux valeurs rencontrées, en limitant le travail d’optimisation à ce moment-là.
Microsoft a déposé en 2010 le brevet Parameter-sensitive plans, US 8 874 547 B2, publié en 2014, avec Cesar A. Galindo-Legaria parmi les inventeurs. Il décrit un répartiteur, un espace de sélectivités découpé en régions et la compilation d’un plan à la première valeur rencontrée dans chaque région. PSP présente des ressemblances avec ce mécanisme, avec trois plages par prédicat. Je n’ai trouvé aucune source établissant que PSP implémente ce brevet.
Des chercheurs de Microsoft Research ont également publié des travaux expérimentaux utilisant SQL Server :
- Anshuman Dutt, Vivek Narasayya et Surajit Chaudhuri, Leveraging Re-costing for Online Optimization of Parameterized Queries with Guarantees, SIGMOD, 2017, p. 1539-1554. Les auteurs évaluent leur technique dans une version modifiée de l’optimiseur de SQL Server 2016.
- Kapil Vaidya, Anshuman Dutt, Vivek Narasayya et Surajit Chaudhuri, Leveraging Query Logs and Machine Learning for Parametric Query Optimization, PVLDB, vol. 15, no 3, novembre 2021, p. 401-413, présenté à VLDB 2022. Leur prototype sur SQL Server 2017 utilise les journaux de requêtes pour choisir les plans à conserver et entraîner un modèle de sélection du plan.
Ces travaux éclairent le problème traité par PSP. Leur présence dans la littérature ne suffit pas à établir un lien avec l’implémentation du produit.
Le Query Store et le cache
Le Query Store garde dans la base les requêtes, leurs plans et leurs statistiques d’exécution, et il survit au redémarrage, ce que le cache ne fait pas : après un redémarrage, le plus ancien plan du cache a l’âge du service. Le Query Store ne remplace pas le cache. Un plan forcé par le Query Store est compilé comme les autres, sous la contrainte du plan forcé, puis mis en cache ; la compilation n’est pas évitée. Les causes de recompilation propres au Query Store (plan manquant, échec du forçage, changement de politique de forçage) apparaissent dans la map des causes.
Plusieurs mécanismes récents stockent leur état dans le plan en cache et le perdent quand il en sort. La rétroaction d’allocation mémoire (memory grant feedback), en mode batch depuis 2017 et en mode ligne depuis 2019, corrigeait l’allocation d’un plan dans le cache seulement, jusqu’à ce que SQL Server 2022 la persiste dans le Query Store, quand celui-ci est activé en lecture et écriture ; sinon, l’éviction du plan la fait toujours perdre. sys.dm_exec_query_plan_stats (2019), qui donne le dernier plan réel connu, ne rend rien pour un plan évincé.
De SQL Server 2022 CU8 à CU11 (corrigé dans CU12), la rétroaction d’estimation de cardinalité a causé une fuite du cache : des plans marqués en cours d’utilisation ne pouvaient plus être retirés, ni par l’horloge ni par DBCC FREEPROCCACHE, et leur nombre montait à 50 000 ou plus.
Les instruments
| Instrument | Ce qu’il montre |
|---|---|
sys.dm_exec_cached_plans | une ligne par entrée : type, taille, usecounts, plan_handle |
sys.dm_exec_plan_attributes | la clé du cache et les compteurs de contextes d’un plan |
sys.dm_exec_query_stats, sys.dm_exec_procedure_stats, sys.dm_exec_trigger_stats, sys.dm_exec_function_stats | statistiques d’exécution, par instruction ou par module, tant que le plan est en cache |
sys.dm_exec_cached_plan_dependent_objects | contextes d’exécution et curseurs d’un plan |
sys.dm_os_memory_cache_counters | taille et nombre d’entrées par store |
sys.dm_os_memory_cache_hash_tables | buckets, longueur des chaînes, succès et échecs de recherche |
sys.dm_os_memory_cache_clock_hands | les deux aiguilles et leurs retraits |
sys.dm_os_memory_cache_entries | coût, taille et état de chaque entrée |
événements sp_cache_insert, sp_cache_hit, sp_cache_miss | insertion, réutilisation, recherche manquée, mais seulement pour un batch non mis en cache ou une session qui attendait un verrou de compilation |
événement sp_cache_remove | retrait explicite (commande DBCC, option de base, vidage d’un store), avec sa méthode et sa raison (38 raisons sur 2025) ; ne voit pas les évictions par l’horloge |
événement plan_not_cached | ce qui n’a pas été mis en cache, et pourquoi (70 raisons) |
événement query_cache_removal_statistics | les statistiques d’une requête au moment où son plan est détruit, y compris par l’horloge : le seul événement qui voit les évictions |
événement sql_statement_recompile | recompilation d’une instruction et sa cause |
compteurs SQLServer:Plan Cache | taux de succès, nombre d’objets, pages, par store, avec quelques secondes de retard |
compteurs SQLServer:SQL Statistics | compilations, recompilations, tentatives de paramétrage |
Aucune page de Learn ne décrit les événements sp_cache_* ni plan_not_cached, et query_cache_removal_statistics n’y est que nommé ; leurs champs se lisent dans sys.dm_xe_object_columns, et les valeurs de leurs maps dans sys.dm_xe_map_values. Une session qui suit les retraits d’un cache, sur une instance de test :
CREATE EVENT SESSION suivi_retraits ON SERVER
ADD EVENT sqlserver.sp_cache_remove (
    ACTION (sqlserver.database_id, sqlserver.sql_text))
ADD TARGET package0.ring_buffer;
GO
ALTER EVENT SESSION suivi_retraits ON SERVER STATE = START;
Le compteur SQL Compilations/sec compte plus que des optimisations. Il monte aussi pour la recherche d’une shell query et pour le paramétrage : sous paramétrage forcé, un site web simulé faisait 4 640 à 5 256 compilations par seconde sans aucune optimisation, ce que montrait sys.dm_exec_query_optimizer_info. Le rapport entre compilations et batchs par seconde ne suffit donc pas à juger qu’une charge est mal paramétrée.
Le cache dans d’autres moteurs
Les autres moteurs ont fait d’autres choix, et la comparaison éclaire ceux de SQL Server.
Oracle partage des curseurs dans la shared pool : un curseur parent par texte exact, des curseurs enfants par plan et par environnement, l’équivalent des options SET de SQL Server. L’optimiseur lit les valeurs des variables liées à la première analyse (bind peeking), le reniflage de SQL Server. Depuis 11g, le partage adaptatif des curseurs (adaptive cursor sharing) apprend après coup, d’après les statistiques d’exécution, qu’un curseur est sensible à ses valeurs, et range des plages de sélectivité par prédicat : c’est PSP, à ceci près que PSP décide à la compilation, d’après l’histogramme. Oracle invalide aussi les curseurs progressivement après un recalcul de statistiques, chacun après un délai aléatoire, ce que SQL Server ne fait pas.
PostgreSQL n’a pas de cache partagé entre sessions : une instruction préparée vit dans sa session. Avec plan_cache_mode = auto, les cinq premières exécutions utilisent des plans personnalisés pour les valeurs reçues, puis le moteur compare leur coût moyen à celui d’un plan générique et garde le générique s’il n’est pas plus cher. Le code ajoute au coût d’un plan personnalisé une estimation du travail de planification, 1000 × cpu_operator_cost × (relations + 1), que son commentaire juge « probablement basse ». PostgreSQL tient ainsi compte du coût de planification dans son choix. SQL Server ne choisit pas entre un plan personnalisé et un plan générique de cette manière.
Db2 a gardé le modèle de System R pour le SQL statique : des packages compilés à l’avance par BIND, invalidés par leurs dépendances. MySQL n’a pas de cache de plans partagé, et a retiré en 8.0 son cache de résultats, qui n’était pas un cache de plans.
Les questions ouvertes
Ce que ni la documentation, ni mes mesures, ni le débogueur n’ont tranché :
- comment
CacheClockAlgorithm::CalculateCost, qui combine des ticks de compilation et des pages, aboutit à la suite 0, 1, 2, 4, 8, 16 mesurée à chaque réutilisation ; - si une réutilisation sous pression remet à son coût d’origine une entrée dont le coût d’origine est inférieur à 16 (les entrées à 16 reviennent à 16) ;
- la fonction qui calcule l’
objectidhaché d’un batch ad hoc, et ce que désigne exactement l’adresse des octets 8 à 15 duplan_handle; - si la « case » du hachage de Zobrist est le rang d’un nœud ou son chemin complet dans l’arbre ;
- l’éviction d’un plan fréquent quand le store est plein de plans préparés, qui demande, pour des plans de 48 Ko, une mémoire cible d’environ 120 Go ;
- la portée de la reconstruction du journal ;
- la règle qui sépare
SensInfoetZeroCostPlanpour les instructions de définition seules dans leur batch ; - la raison pour laquelle une exception détruit le contexte d’exécution, que je déduis sans l’avoir lue dans le code.
Bibliographie
Les références suivantes regroupent les sources citées dans l’article, avec les éditions utilisées et les chapitres pertinents.
Livres
- Mara Bos, Rust Atomics and Locks, O’Reilly, 2023. Chapitre 7, « Understanding the Processor », instruction x86 de comparaison et échange.
- Andrew S. Tanenbaum et Herbert Bos, Modern Operating Systems, Pearson, 5e édition, 2023 (publiée en octobre 2022). Chapitre 3, « Memory Management », algorithmes de remplacement de pages et vieillissement.
- Jonathan Kehayias et Ted Krueger, Troubleshooting SQL Server: A Guide for the Accidental DBA, Redgate, 2011. Discussion de la mémoire et de la taille du cache de plans sous SQL Server 2005 et 2008.
- Kalen Delaney et al., Microsoft SQL Server 2012 Internals, Microsoft Press, 2013. Chapitre 12, « Plan caching and recompilation », rédigé par Kalen Delaney, notamment la section « Cache stores » et le tableau 12-1.
- Kalen Delaney et al., Inside Microsoft SQL Server 2005: Query Tuning and Optimization, Microsoft Press, 2007. Chapitre 5, « Plan Caching and Recompilation », également disponible dans les archives Microsoft.
- Dmitri Korotkevitch, Pro SQL Server Internals, Apress, 1re édition, 2014. Chapitre 26, « Plan Caching ».
- Grant Fritchey, SQL Server Execution Plans, Redgate, 3e édition, 2018. Sections « Plan aging », p. 35, et « Criteria for plan reuse », p. 36, et chapitre 9, « Exploring Plan Reuse ».
- Grant Fritchey, SQL Server 2025 Query Performance Tuning: Troubleshoot and Optimize Query Performance, Apress, 7e édition, 2026. Chapitre 2, « Execution Plan Generation and the Query Optimizer », section « Aging of the Execution Plan », p. 37-38 ; chapitres 7, « Execution Plan Cache Behavior », et 8, « Query Recompilation ».
- Steven Wort et al., Professional SQL Server 2005 Performance Tuning, Wrox/Wiley, 2008, ISBN 9780470176399. Extrait de l’éditeur.
Livres blancs Microsoft
- Arun Marathe, révision par Shu Scott, Batch Compilation, Recompilation, and Plan Caching Issues in SQL Server 2005, Microsoft, mise à jour de décembre 2006.
- Greg Low, Plan Caching in SQL Server 2008, Microsoft, août 2009.
- Greg Low, Plan Caching and Recompilation in SQL Server 2012, Microsoft, mars 2013. Voir notamment les contextes d’exécution, les sections parallèles, les clés du cache et l’annexe A sur le paramétrage simple.
Articles et rapports de recherche
- Anshuman Dutt, Vivek Narasayya et Surajit Chaudhuri, Leveraging Re-costing for Online Optimization of Parameterized Queries with Guarantees, ACM SIGMOD, 2017, p. 1539-1554, DOI 10.1145/3035918.3064040.
- Kapil Vaidya, Anshuman Dutt, Vivek Narasayya et Surajit Chaudhuri, Leveraging Query Logs and Machine Learning for Parametric Query Optimization, PVLDB, vol. 15, no 3, novembre 2021, p. 401-413, DOI 10.14778/3494124.3494126.
- Redha Gouicem, Operating Systems and System Software, RWTH Aachen. Section « Page Replacement: LRU Approximation With Aging ».
- Edsger W. Dijkstra, Recursive programming, Numerische Mathematik, vol. 2, 1960, p. 312-318.
- Donald D. Chamberlin et al., A History and Evaluation of System R, Communications of the ACM, vol. 24, no 10, octobre 1981, p. 632-646.
- Fernando J. Corbató, A Paging Experiment with the Multics System, dans In Honor of Philip M. Morse, MIT Press, 1969, p. 217-228.
- Victor F. Nicola, Asit Dan et Daniel M. Dias, Analysis of the Generalized Clock Buffer Replacement Scheme for Database Transaction Processing, ACM SIGMETRICS, 1992.
- Neal E. Young, On-Line Caching as Cache Size Varies, ACM-SIAM SODA, 1991. Version en revue : The k-server dual and loose competitiveness for paging, Algorithmica, vol. 11, no 6, 1994, p. 525-541.
- Pei Cao et Sandy Irani, Cost-Aware WWW Proxy Caching Algorithms, USENIX USITS, 1997, p. 193-206.
- Albert L. Zobrist, A New Hashing Method with Application for Game Playing, rapport technique 88, université du Wisconsin, 1970.
- J. Lawrence Carter et Mark N. Wegman, Universal Classes of Hash Functions (Extended Abstract), ACM STOC, 1977, p. 106-112. Version en revue : Universal Classes of Hash Functions, Journal of Computer and System Sciences, vol. 18, no 2, 1979, p. 143-154.
- Mihai Pătrașcu et Mikkel Thorup, The Power of Simple Tabulation Hashing, ACM STOC, 2011, p. 1-10. Version longue des auteurs.
- Yannis E. Ioannidis, Raymond T. Ng, Kyuseok Shim et Timos K. Sellis, Parametric Query Optimization, VLDB, 1992, p. 103-114. Version longue : Parametric query optimization, The VLDB Journal, vol. 6, no 2, 1997, p. 132-151, DOI 10.1007/s007780050037.
- Sumit Ganguly, Design and Analysis of Parametric Query Optimization Algorithms, VLDB, 1998, p. 228-238.
Billets techniques
- Slava Oks, SQLOS Caching, 18 mars 2005, et Q and A: Clock Hands - what are they for?, 20 novembre 2005, archives Microsoft.
- Sangeetha Shekar et l’équipe SQL Programmability, série sur le cache de plans, janvier 2007, notamment 6.0 Best Programming Practices, 7.0 Costing Cache Entries et 9.0 Memory Pressure Limits. Les dates de republication des archives diffèrent des dates des billets d’origine.
- Équipe SQL Server, Name resolution, default schema, implicit schema Part I, publié initialement le 3 avril 2006. Passage « Active Default Schema ».
- Bart Duncan, Query Fingerprints and Plan Fingerprints: The Best SQL 2008 Feature That You’ve Never Heard Of, 3 septembre 2008.
- Aaron Bertrand, Multiple Plans for an « Identical » Query, SQLPerformance, 20 novembre 2014.
- Paul White, Simple Parameterization and Trivial Plans, SQLPerformance, 2022 : partie 1, partie 2, partie 3, partie 4, partie 5, partie 6.
- Paul White, Parameter Sniffing, Embedding, and the RECOMPILE Options, SQLPerformance, 28 août 2013.
- Erland Sommarskog, Slow in the Application, Fast in SSMS? Understanding Performance Mysteries, notamment les sections sur les clés du cache, le schéma par défaut et l’autoparamétrage.
- Kendra Little, Query Hash Values Are Meaningless in SQL Server: They May Be Reset to Be the Same Value as the Query Plan Hash, 24 novembre 2024.
Documentation Microsoft
- Microsoft, Editions and supported features of SQL Server 2022 et Editions and supported features of SQL Server 2025, tableaux « Intelligent query processing », disponibilité de PSP par édition.
- Microsoft, SQL Server, Plan Cache object et sys.dm_exec_procedure_stats, compteurs du cache et date de mise en cache des plans de procédures.
- Microsoft, Query Processing Architecture Guide, notamment les sections « Execution context », « Cache multiple plans for the same query » et « Remove execution plans from the plan cache ».
- Microsoft, Memory Management Architecture Guide.
- Microsoft, sys.dm_exec_cached_plans et sys.dm_exec_plan_attributes.
- Microsoft, sys.dm_exec_query_stats et sys.dm_exec_cached_plan_dependent_objects.
- Microsoft, sys.dm_os_memory_objects et sys.dm_os_memory_cache_entries.
- Microsoft, sys.dm_os_memory_cache_counters, sys.dm_os_memory_cache_hash_tables et sys.dm_os_memory_cache_clock_hands.
- Microsoft, sys.query_store_query.
- Microsoft, sp_executesql, notamment la section « OPTIMIZED_SP_EXECUTESQL ».
- Microsoft, Server Configuration: optimize for ad hoc workloads.
- Microsoft, ALTER DATABASE SCOPED CONFIGURATION et DBCC FREEPROCCACHE.
- Microsoft, CREATE PROCEDURE et Execute a Stored Procedure.
- Microsoft, sqlcmd utility, option
-I. - Microsoft, Configure parameters with Microsoft.Data.SqlClient et SqlParameter.Size.
- Microsoft, Troubleshoot blocking issues caused by compile locks, notamment la section « Stored procedure is invoked as a Language event ».
- Microsoft, KB3026083, SOS_CACHESTORE spinlock contention on ad hoc SQL Server plan cache causes high CPU usage, limite d’entrées et indicateur de trace 174.
- Microsoft, Parameter Sensitive Plan optimization, plans répartiteurs, variantes et problèmes connus.
Structures de données
- NIST, Load factor, Dictionary of Algorithms and Data Structures. Définition du facteur de charge d’une table de hachage.
- Robert Sedgewick et Kevin Wayne, supports d’Algorithms, section 3.4, « Hash Tables », Princeton. Diapositive 20, « Analysis of separate chaining », page 5 du PDF : dimensionnement courant
M ≈ N / 4. - Équipe Tcl,
generic/tclHash.c. ConstanteREBUILD_MULTIPLIERet agrandissement des tables de hachage.
Autres moteurs
- PostgreSQL Global Development Group,
buf_internals.h, branche PostgreSQL 18. Définition du mot d’état des buffers et mises à jour atomiques. - Oracle, Improving Real-World Performance Through Cursor Sharing, Oracle Database 19c SQL Tuning Guide.
- PostgreSQL Global Development Group, PREPARE, documentation PostgreSQL 18, et plancache.c, notamment la fonction
choose_custom_plan. - Oracle, What Is New in MySQL 8.0, section sur les fonctionnalités retirées, dont le cache de résultats.
Normes et brevets
- Roy T. Fielding, Mark Nottingham et Julian Reschke, HTTP Caching, RFC 9111, juin 2022. Section 2, clé d’un cache HTTP.
- Nimish S. Khanolkar, Pawel Terlecki, Cesar A. Galindo-Legaria, Yavor V. Angelov, Mostafa Elhemali et Pooja N. Darera, Parameter-sensitive plans, US 8 874 547 B2, Microsoft. Dépôt le 4 janvier 2010, publication le 28 octobre 2014.
Scripts et corrections de documentation
- Rudi Bruchez, Plans multiples pour un même texte, dépôt
TSQL-Scripts. - MicrosoftDocs/sql-docs, PR #10501, Correct plan stub identification and clarify database cache clearing, proposition de correction envoyée le 15 novembre 2026.
- MicrosoftDocs/sql-docs, PR #10502, Correct the database scope of plan cache removal for ALTER DATABASE, proposition de correction envoyée le 15 novembre 2026.